
团队知道资料已经放进知识库,却仍然搜不到想要的那一句话,这是很消耗信任的体验。文件名能找到,附件也能打开,搜索结果却没有给出内容。使用者很容易开始怀疑:是资料没进去,还是搜索没有覆盖它?
问题常常出在“文件存在”和“有可搜索的文字”之间。PDF、文档或图片保存为附件之后,是否另有文本被提取并写入,直接影响搜索能看到什么。继续换关键词,未必能跨过这一层差别。
排查应从资料的实际形态开始。先弄清内容有没有对应的文字、文字是否完整和及时,再判断搜索结果是否合理,比把每次未命中都归结为检索能力更有用。
零结果之前,先读 coverage
调用 grep 后,先查看 coverage 和 truncated。missing、stale、errored、notReached 或 truncated 为 true,都说明不能把结果当成完整范围内的否定结论。按来源检查:有些文件缺文本,有些来源没扫到,有些调用被截断。
范围不完整时,先缩小来源,再按 Base slug 或 Drive 路径缩小范围,不要只不断提高 maxMatches。文件缺文本则补文本,源已变则重提取;这些问题不是换关键词能解决的。
命中包含来源、行、列和附近上下文。先定位,再按有限行范围读回文件或 Doc,核对原句是否支持结论。文件命中还标明归属的 Skill 或 Drive,便于把同名文件分清。
上传文件与可搜索文本是两件事
搜索文档说明,Markdown、JSON、CSV等文本使用自身 UTF-8 内容;PDF、办公文档、图片、音视频等二进制文件,需要外部工具或 Agent 提取、OCR 或转写,再把文本提供给 Asset。Busabase 存储和搜索这些文本,不内置 OCR、转写或文档解析器。
因此,先问这次搜索读的是什么表示。文件可以正常下载,不代表它已经有完整、当前的文本可供 grep 使用。
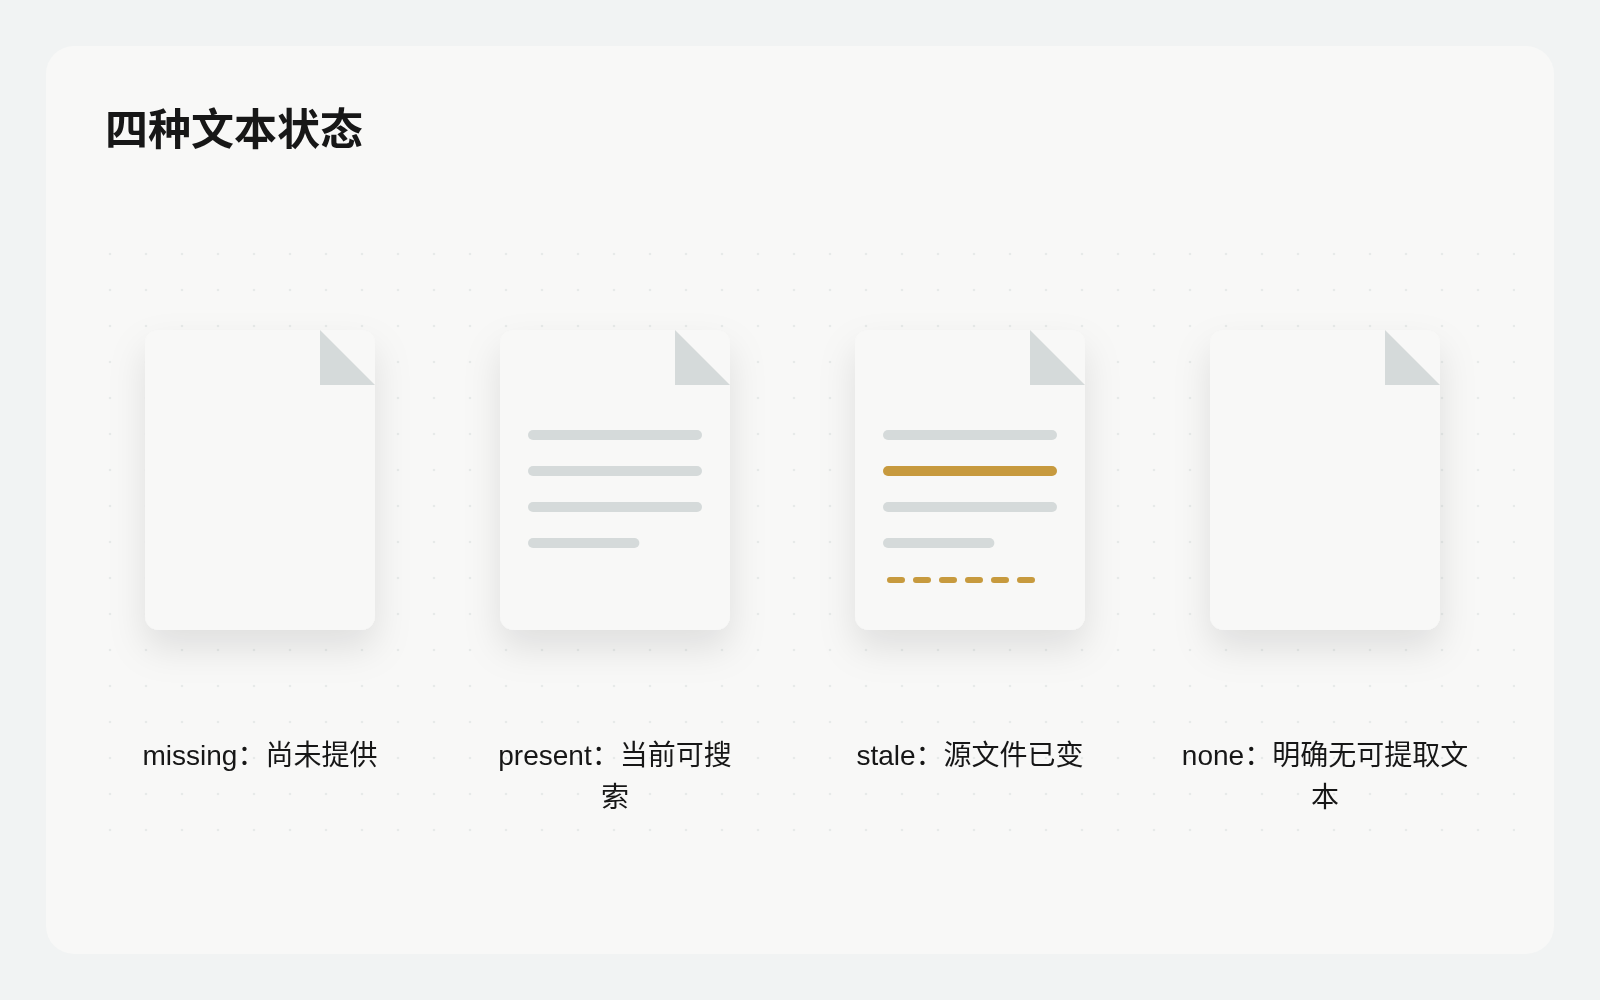
| textStatus | 含义 | 下一步 |
|---|---|---|
| missing | 尚未提供搜索文本 | 提取后提供,或明确无可提取文本 |
| present | 当前有可搜索文本 | 搜索并检查实际命中 |
| stale | 提供文本后源文件发生变化 | 按新源文件重新提取 |
| none | 已明确标为无可提取文本 | 后续具备提取条件时可再提供 |
none不是业务上“没有内容”的结论。它只说明当前对这个文件的可提取文本作了明确标记。
先选对搜索方式
找团队有没有保存做法,用 playbooks search;找文字准确出现在哪里,用 grep;找相关内容并按相关性排序,用 search。search 也包括待审 ChangeRequest 草稿,但长字段只匹配前 8,000 个字符,核对完整措辞时应使用 grep。
grep 覆盖文件、Doc正文、当前已合并的记录字段与节点上的自定义提示词。待审草稿与当前合并值需要分开判断,不能把两种搜索返回差异直接当数据丢失。
让提取内容与当前源文件一致
Asset详情可提供、替换和预览搜索文本。API 中 putText 写入 UTF-8 文本;不超过 1MB 可内联,较大文本先上传再绑定。再次提供会替换原搜索文本。源文件更新后,应从新文件重新提取,而不是继续把旧结果当当前依据。
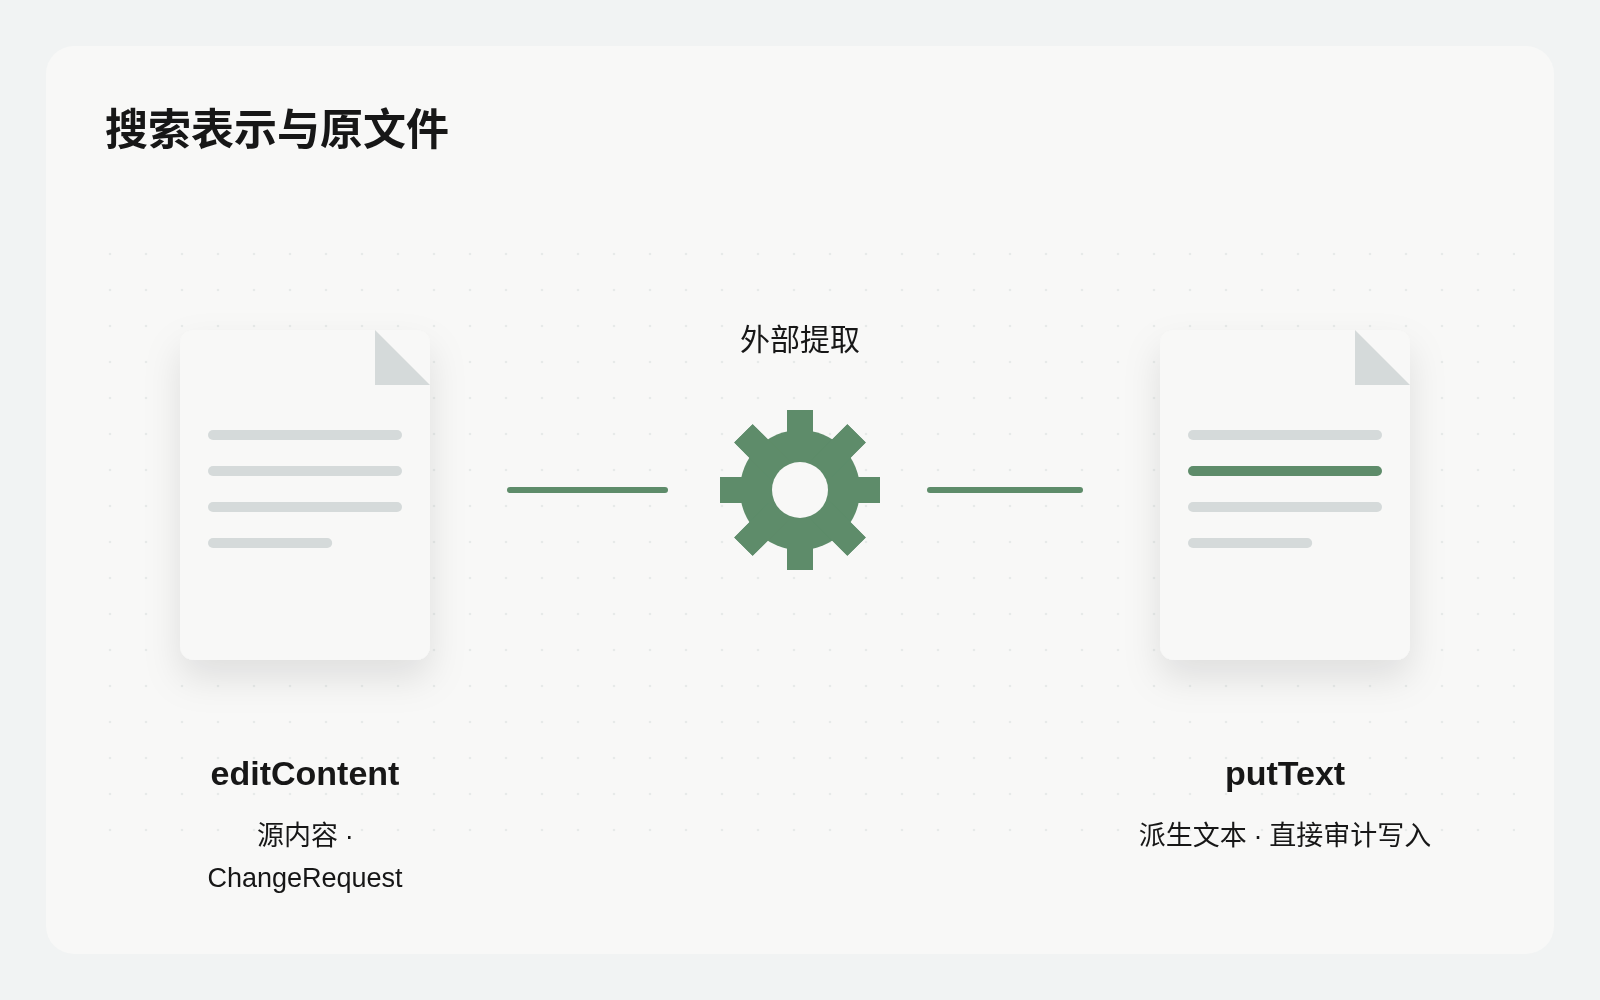
putText 修改的是用于搜索和分行读取的派生表示,直接写入并有审计记录,不会改 PDF 或原文件内容。editContent 修改挂载的 Drive 或 Skill 文本文件源内容,走 ChangeRequest;有写权限可立即合并,否则等待审阅。不要用 putText 来修改正式源文件。
提取前要确认工具及数据使用权限,尤其涉及外部 OCR 或转写服务时。保留源文件版本或其他可追查依据和提取结果的关联,避免无法说明文本来自哪份文件。
把排查变成一次可复用检查
可以复用资料维护 Base,建议记录源 Asset、资料负责人、文本状态、源变更依据、提取方式、检查时间、搜索覆盖缺口和下一步。它是维护清单,不会自动执行提取或提高召回率。原文放在对应文件,清单用来追踪哪些工作尚未完成。
需要委托Agent时,可以这样描述任务
检查指定知识库中与这个问题相关的文件文本状态。先列 missing、stale 和 none,再在已覆盖范围内执行精确搜索,报告 coverage、truncated 和命中位置。按行读回相关原句,区分没有命中与没有完整覆盖。只做读取,不重新上传文件、不调用外部提取服务、不改搜索文本。
待负责人确认后,再让有权限的 Agent 对缺失或过时的文件完成提取与供给,并用同一问题、相同范围复查。验收看状态、覆盖与引用原句是否当前,不编造一个没有实测依据的召回率。
零命中之后,先补哪一种缺口
missing要补的是可搜索文本,stale要处理源文件与提取结果的版本关系,truncated提示范围可能不完整。这三者不能用“重新搜一次”统一处理。none则表示已经明确没有可提取文本,仍要核判断依据是否符合当前文件,而不是无限重复OCR。
有命中也要回到原文。命中行只是定位入口,可能截断条件或跨越表格关系。读回相关行及必要上下文,再给出结论和出处;需要修改原文件时走对应源内容操作,不用putText把派生文本改成希望搜到的答案。
下一次更新资料时一起更新搜索依据
把源文件变更后的文本检查纳入资料维护:谁更新源,谁确认对应文本是否需要重新提供,以及谁检查最终可搜索状态。先从一份确实未命中的文件做完这一轮,再推广到资料集。
搜索不到时,最有用的结果不是一句“再试试”,而是指出哪份文件缺少哪种可搜索表示,以及哪条原文最终支持回答。