
核对客户资料、盘点待办或汇总业务记录时,Agent 很容易在读到一批数据后就开始总结。回答可以条理清晰,引用也都真实,却仍然漏掉后面的记录。问题出在“读到了数据”与“读完了约定范围”之间。
完整读取需要一个明确终点,以及能够复查的覆盖账本。在 Busabase 中,这意味着固定 Base 和记录状态,沿服务端返回的游标读到结束,再从每条记录的当前提交中取值。总结应该建立在这些条件上。
先约定整张表到底指什么
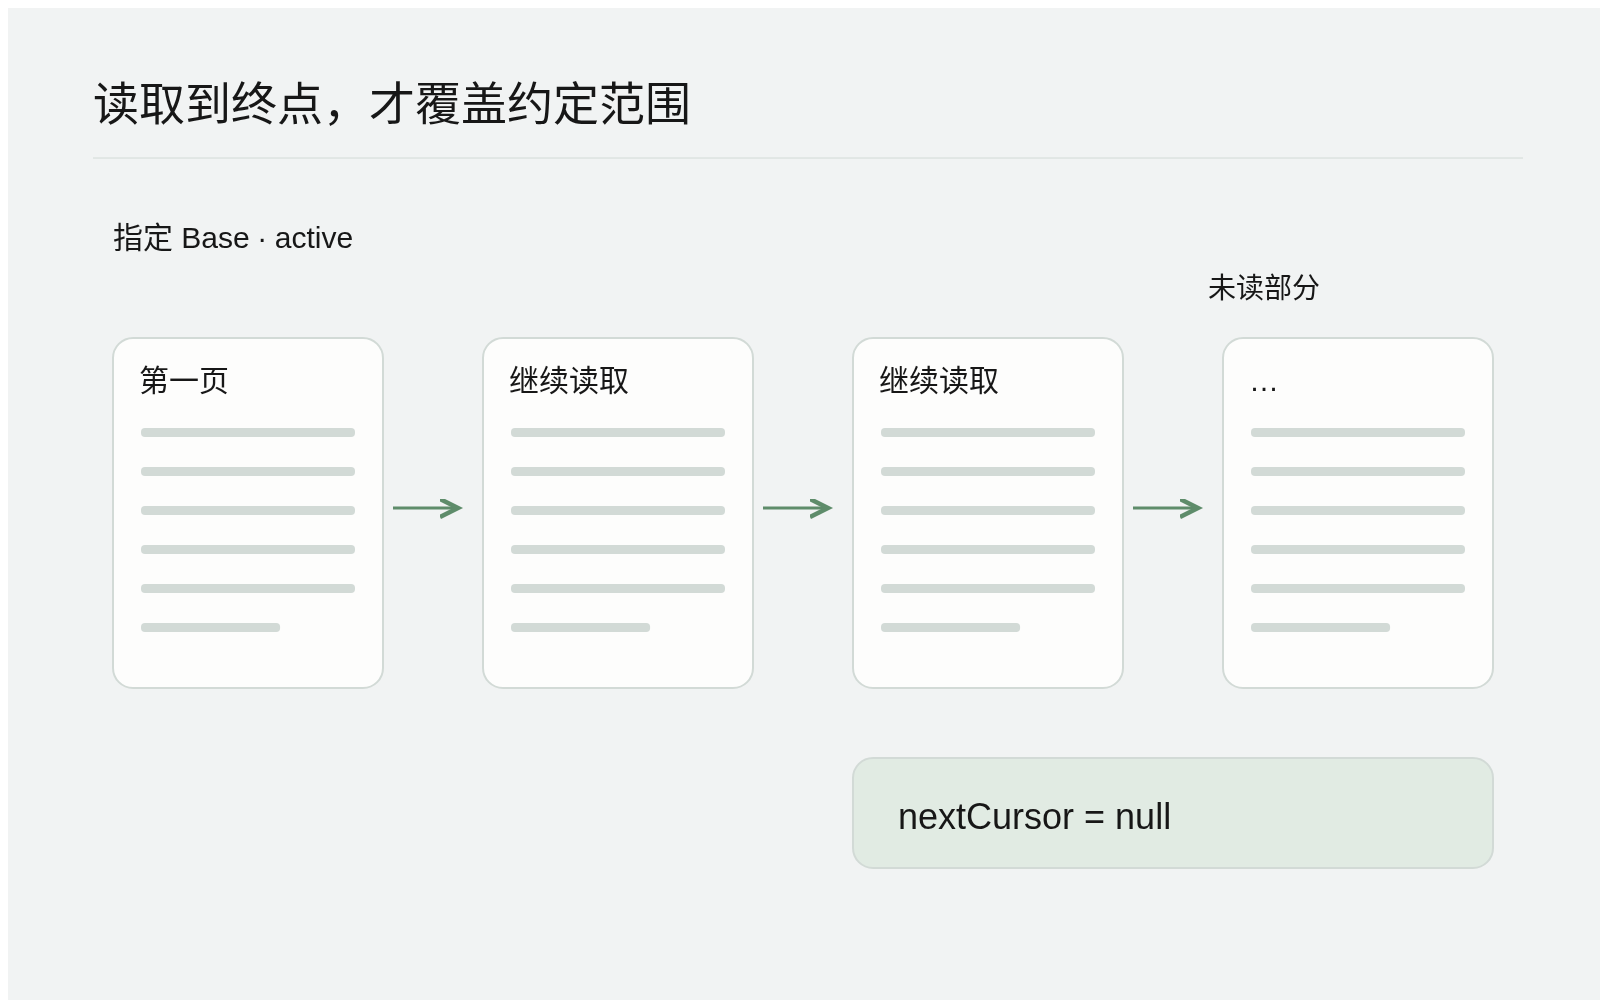
Records 文档中的记录属于特定 Base。调用读取接口时显式传入 baseId;省略它会扩大到整个 Space。还要决定读取 active 还是 archived:前者是当前记录,后者是回收站,两者不能混成一份业务清单。
把过滤条件、开始时间、是否包含归档、需要核验的字段写进本次任务说明。若问题只是核对当前有效客户,就不要把历史归档也算进分母。若只查某个状态,结论也只能覆盖这个状态。
结构示意 · 可调整的工作方法
第一页有一百条,也可能只是一部分
实时 OpenAPI规定 records.list 的 limit 最大为 100。响应中的 records 是本页数据,nextCursor 是下一页入口。下一次请求原样带回这个游标,直到 nextCursor 为 null。不要解析游标,也不要用“这一页不足一百条”替代接口明确返回的终点。
每页保存返回条数、读取时间及是否还有下一页;按 recordId 检查重复。网络错误时保存已完成页与下一游标,恢复同一读取范围。任何一页失败,都应把任务标为部分完成,而不是直接输出全表结论。
取当前值,不要从记录外壳猜内容
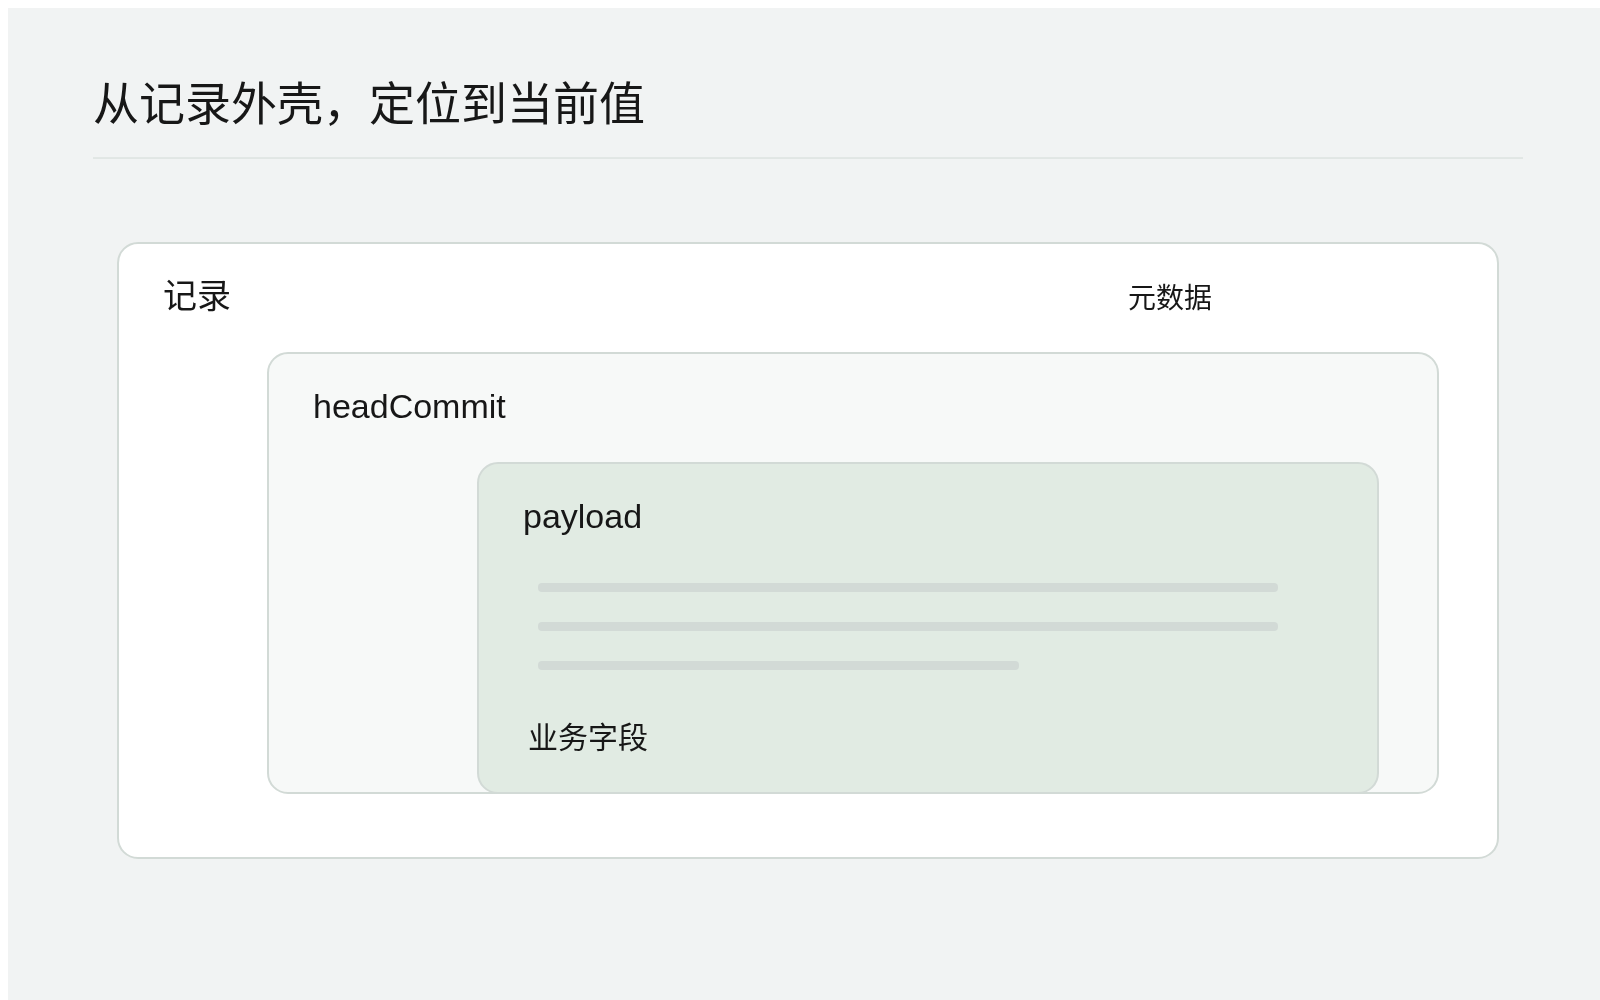
业务字段在 records[].headCommit.payload 中,使用字段 slug 读取。createdByUser、base、提交作者和外层 status 是记录元数据,不能当作同名业务字段。payload 没有某个 slug,就把它视为空,不用关联对象或旧提交补成一个看似完整的值。
summary=true 会把超过 4 KB 的字段换成省略标记。它适合列表定位,不适合直接审核长正文。先定位候选,再用 records.get 读完整记录,并核对 headCommitId,避免把省略标记当成原文。
结构示意 · 可调整的工作方法
筛选和排序也会改变结论
records.list 的 filters 是尽力返回的超集,客户端还需逐条复核;不能看到 limit 条结果就认定全部符合条件。需要精确值比较时,使用支持的 valueFilters;它要求指定 Base,并对不支持的字段比较报错。
排序同样有边界:number 和 date 字段提供可靠的服务端排序,其他类型不能据此推断“最新”或“最高优先级”。接口的具体参数以当前 OpenAPI 为准,不把界面上看见的排序效果自动套到所有读取方式。
交付覆盖账本,再交付判断
可以给已连接的 Agent 这样下指令:
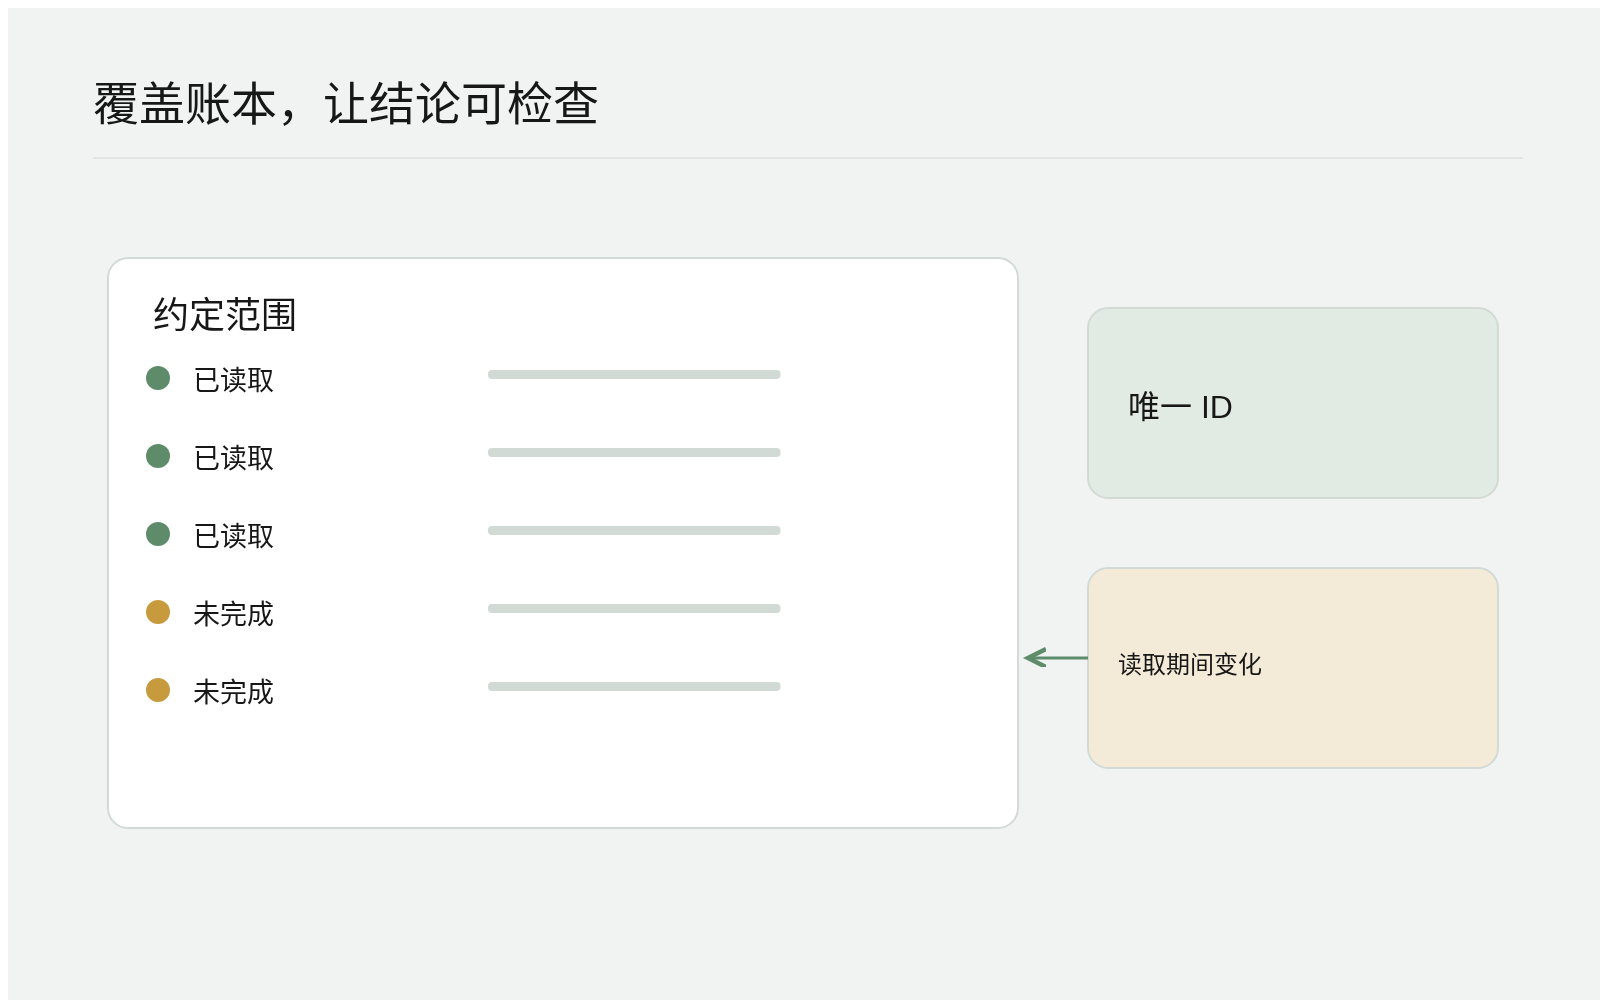
只读指定 Base 的 active 记录,按原样游标遍历到 nextCursor=null。保存每页条数、recordId 与 headCommitId,业务值只取 headCommit.payload。长字段被省略时另读完整记录。报告重复 ID、空字段、失败页及读取起止时间;未读完时不要声称全表核对完成。
输出至少包含读取范围、页数、返回总数、唯一 ID 数、失败情况和终点证据。计数可以辅助交叉核验,但读取期间若有人新增或修改记录,先后请求未必代表同一个瞬间;游标遍历本身不承诺快照隔离。关键结论提交前,重读涉及记录的当前 head,变化时重新判断。
结构示意 · 可调整的工作方法
让下一步动作建立在真实覆盖上
阅读与写入是两项验收。全表读完之后,仍应逐条检查建议是否有依据,再通过 ChangeRequest 提出必要修改。一次成功的列表请求,也没有授予批量修改或对外发送的权限。
从一个明确 Base 和一个业务问题开始,在连接与 REST API 指南中确认接入方式。把覆盖账本随结论保存,下次接手的人就能知道:检查了什么,遗漏了什么,哪些记录在检查后又变了。