
10 月 30 日,YC 的播客 Lightcone 请来 Supabase 联合创始人兼 CEO Paul Copplestone,标题本身就是一个预言:《每个人都将拥有自己的数据库》(Why Everyone Is About To Have Their Own Database)。数字摆在那里:Supabase 注册用户 1300 万,一年前约 300 万;每周新建数据库超过 100 万个;托管的数据库总量逼近 5000 万,一年前还是 800 万。主持人还提到,如今约 70% 的新活动来自 Agent,而不是人。
Copplestone 把理由说得很直白:你要拥有自己的数据库,然后在它之上构建所有的应用和 Agent——数据库是记录的存放处(store of record),应用和 Agent 来来去去,它才是留下来的东西。
同一期节目里还有两个「个人版」的样本。YC 合伙人 Harj Taggar 讲了他给自己搭的个人系统:邮件分诊、财务、健康都在一个地方;他还刻意把自己的 CRM 从单个 Agent 里抽出来独立存放,这样「想在上面接哪个 Agent 都行」。他的结论是:「一年前我根本不会想要一个个人数据库……但现在,它恰恰是最有价值的东西。」而 Garry Tan 的 GBrain——建在 Supabase 上的个人 Agent 大脑——为的也是同一件事:Agent 只能看见当前上下文窗口,就会反复问你早就回答过的问题。
这期节目的判断我们认同。这篇文章要补的,是它没展开的那一层。
有数据库,不等于有一个能干活的个人数据库
Postgres 是给应用读写的:存放层就该这样。但你本人不会在 Postgres 里工作,你的 Agent 也不该被直接扔进一堆裸表里。
人和 Agent 每天真正打交道的,是另一层:人物、会议、决策、项目、经验。这些东西是记录,不是要背 schema 才能读的行。它们需要同时满足三件事:你扫一眼就能看懂;你接的任何 Agent 都能读写;一旦写的人或 Agent 不止一个,每次改动都得有作者、有历史、能审。
Busabase 就是这一层。它不是 Postgres 的替代品——Busabase 自己就跑在 Postgres 或嵌入式数据库 PGlite 上,官方 README 写得很清楚:它是上面的工作空间,不是你应用数据库的替代。应用数据继续放在它该在的地方;而 Agent 生活的记录层,不必自己拼 Postgres + 向量库 + 图数据库。Busabase 开源版装起来,就是这一层,一条命令的事。
安装:一条命令,没有数据库要你先配
在自己机器上:
npx -y busabase@latest server
然后打开 **http://localhost:15419/dashboard/local**。不需要先装数据库、不需要账号、不需要写配置:服务自带嵌入式 PGlite、本地文件存储,还带一个演示工作区,可以逛一圈再清掉。数据就住在你机器的 ~/.busabase/data/ 里。
其他形态也齐全,都是同一个引擎、MIT 开源:Docker(docker run --rm -p 15419:15419 -v ~/.busabase/data:/data busabase/busabase)、全局安装(npm i -g busabase 后运行 busabase server)、或者 busabase.com/download 的桌面版(macOS / Windows / Linux)。驱动 Busabase Cloud 的就是这同一个引擎。
继续之前,有一条边界是官方自己写明、值得先讲清的:开源版服务器是为可信的本机或内网设计的,不要把它的写接口在没有认证和反向代理的情况下暴露到公网。个人数据库的价值来自「是你的」,守住这一点,它才是你的。
把安装交给你的 Agent:可直接复制的提示词
GBrain 的 INSTALL_FOR_AGENTS.md 做对了一件事,这篇文章也照此办理:2026 年,读安装文档的越来越多是 Agent。所以这里不给一页手动步骤,给一段提示词。在你希望个人数据库落地的那台机器上,把下面这段贴给你已经在用的 Agent——Claude Code、Codex、Cursor,或任何能执行命令、能读 URL 的 Agent:
你是我的安装 Agent。请在这台机器上安装 Busabase,并为我建好个人数据库。
只走下面给出的官方路径,不要自创命令或表结构;任何一步失败就停下来报告,
不要绕行解决。

1. 如果服务还没启动,先启动它:
   npx -y busabase@latest server
   仪表盘地址是 http://localhost:15419/dashboard/local。它不需要账号,
   也不需要另配数据库——自带嵌入式数据库和本地文件存储。

2. 阅读并遵循 Busabase Agent Skill,它是接入这个工作区的唯一事实来源:
   http://localhost:15419/SETUP_SKILL.md
   所有工作区操作都用 busabase-cli 连本地服务(http://localhost:15419)执行。

3. 在这个工作区里新建一个文件夹「Personal Base」,包含:
   - Base「People」:姓名 · 职务 · 组织 · 联系链接 · 背景 · 最近联系日期
   - Base「Meetings & Decisions」:标题 · 日期 · 与会人(关联到 People) ·
     决定 · 为什么 · 后续事项
   - Base「Projects」:名称 · 状态 · 负责人 · 关键决定(关联到
     Meetings & Decisions) · 下一步 · 链接
   - Base「Experience」:经验(一句话) · 来源记录 · 适用范围 · 不适用范围 ·
     状态(候选 / 已采纳 / 已退役)
   - Doc「How I work」:什么该进这个库、什么永远不进、哪些事永远等我批准——
     钱、承诺、日期
   - Skill「Personal Base operator」:每次任务前先查 People、
     Meetings & Decisions 和已采纳的 Experience;每次任务后把结果连同来源
     写回;同一个联系链接绝不建第二条 People 记录——更新已有的那条

4. 完成后验证:把新建的节点列给我,并从每个 Base 各读出一条记录,
   证明结构真实存在。然后汇报仪表盘地址、你建了什么、以及我应该先
   检查哪一处。

5. 永远不要自己选合并策略——每次变更都提交,由我的权限决定它是当场
   合并还是等我审。任何记录里都不要存密码、令牌或任何秘密。
这段提示词里的每一步都只有官方机制:启动命令和接入 Skill 出自项目 README,结构就是下一节的蓝图。它换来的是分工:重复性的搭建由 Agent 做,你只在最后验收一遍。
蓝图:个人数据库里装什么
这是一个刻意做小的起步设计(starter design):一个文件夹里,四张 Base、一份 Doc、一个 Skill。
| 节点类型 | 建议名 | 关键字段 / 内容 | 用途 |
|---|---|---|---|
| 文件夹 | Personal Base | — | 把下面所有东西收在一处 |
| Base | 人物 People | 姓名 · 职务 · 组织 · 联系链接(去重键) · 背景 · 最近联系日期 | 一人一条;Agent 认人靠联系链接,不靠同名 |
| Base | 会议与决策 Meetings & Decisions | 标题 · 日期 · 与会人(关联→People) · 决定 · 为什么 · 后续事项 | 决定和理由一起留下,不消失在聊天里 |
| Base | 项目 Projects | 名称 · 状态 · 负责人 · 关键决定(关联→Meetings & Decisions) · 下一步 · 链接 | 新 Agent 接手先读它,不用重新交代 |
| Base | 经验 Experience | 经验一句话 · 来源记录 · 适用范围 · 不适用范围 · 状态(候选/已采纳/已退役) | 纠正沉淀成可复用的判断,而不是一次性返工 |
| Doc | 工作口径 How I work | 什么进库、什么永远不进、钱/承诺/日期的审批规矩 | 你立的标准,Agent 动手前先读 |
| Skill | 个人库作业 Personal Base operator | 日常回路、写回规范、去重键、失败即停清单、汇报格式 | 每个接入的 Agent 都按同一套方法干活 |
真正起作用的是两个设计。其一,决定单独成行,还带「为什么」一列:半年后,决定本身不值钱,理由才值钱,而理由恰恰是聊天最先弄丢的东西。其二,经验要过一道采纳门:Agent 提出的经验先是「候选」,你确认过的才变「已采纳」,只有已采纳的才会在每轮任务开始时被读到。这道门,决定了你的个人数据库不会积满自信的废话。
举个虚构的小例子(示例):周一 9:00,Agent 读完上周的会议记录,把今天的优先级草案发到聊天里。你回一句:「供应商电话挪到周四——周一上午不约外部电话。」Agent 改了日程,把变更写回会议记录,并在经验表里新增一条候选:「周一上午不约外部电话。」你标为已采纳。下一个周一,草案已经自带这条规矩;三个月后你换了 Agent,新 Agent 照样遵守——因为这条经验存在库里,不在旧 Agent 身上。
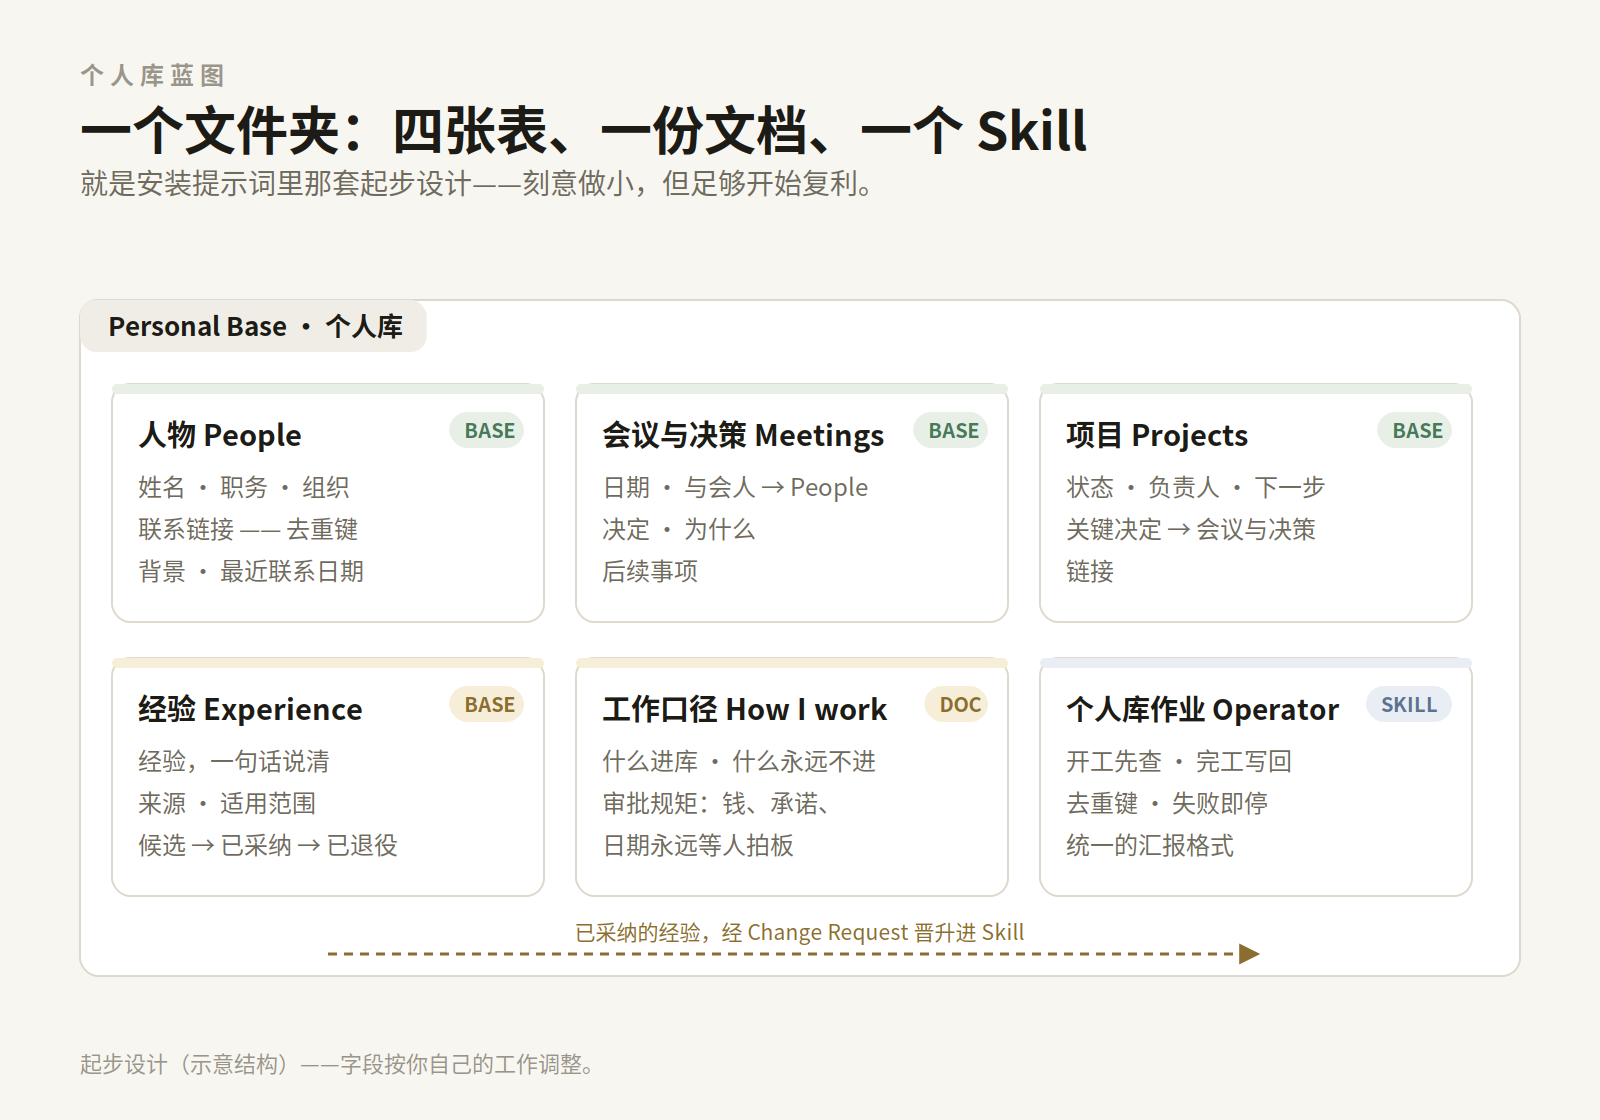 起步蓝图(示意)。字段按你自己的工作调整。
日常回路:先查、再干、写回留痕
个人数据库能不能复利,取决于回路是否每天都在转。收成三步即可:观察 → 决策 → 行动。
- 开工先查。 今天未完的后续事项、相关的人物与决策、已采纳的经验,先读一遍。「不要重复问已经回答过的问题」靠的就是这一步——答案通常已经在库里。
- 提案进聊天,人来拍板。 简报、回复、计划,Agent 先出草案,你同意、修改或驳回。涉及钱、承诺、日期的,永远停在这一步,按你的 Doc 执行。
- 完工写回。 结果落回它所属的记录,并带上来源。这样明天这一轮、明年那个 Agent,读到的是实际发生了什么,而不是当初计划了什么。
Busabase 的写入以 Change Request 形式旅行:每次变更都带说明、字段级 diff、作者和历史。本机单人单 Agent 时,多数变更当场合并——但 diff 和历史都在,「改了什么、谁改的」永远可查。写入失败时,遵守安装提示词里的规矩:停下来报告,绝不自行绕行。
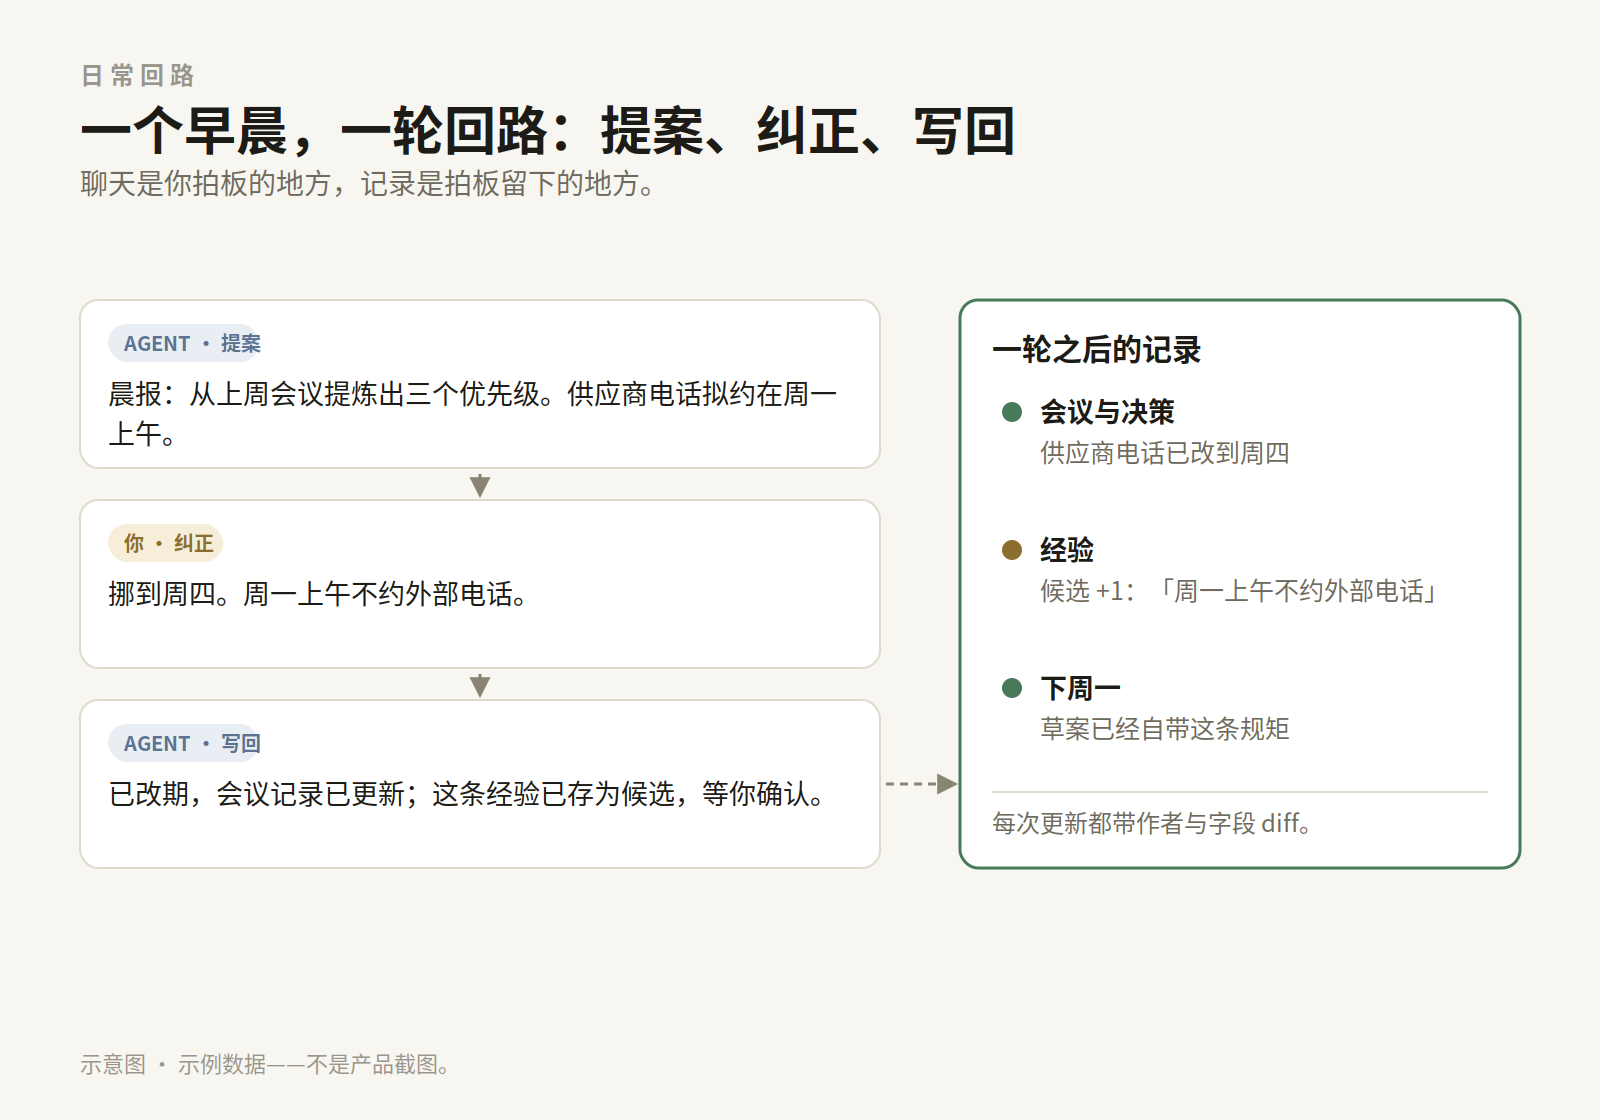 一轮回路全程(示意图,示例数据,不是产品截图)。
长大之后:团队、企业,和一组 Agent
个人数据库是模式的起点,不是终点。第二个真人——或第二个分工不同的 Agent——一进来,四种痛会按固定顺序出现:
- 两个写手,两份真相。 一个 Agent 的笔记留在它的聊天里,另一个的散在某份文档里,没人说得清哪版决策算数。
- 改动没有作者。 一条记录昨夜变了。是研究 Agent、排期 Agent,还是人改的?没有出处,每次意外都是一场调查。
- 每个新 Agent 都要重新交代。 知识长在上一个 Agent 里,换工具就得把项目再讲一遍。
- 所有东西对所有人可见。 财务的行和实习生的试验田躺在同一层——因为个人版从来不需要边界。
这正是同一套系统的共享形态要解的问题。Busabase Cloud 是同引擎的托管多用户版:空间(Space)加角色与权限,决定谁——人或 Agent——能看什么、能改什么。Change Request 成为协作协议:每次改动都带 diff、作者和历史;有写权限的凭证直接合并,凭证也可以被限定为「只能提案、不能落地」,这时改动留在收件箱等人审。某个 Agent 写出的 Skill 进入共享的 Playbooks 目录,所有接入的 Agent 动手前都能查到同一份手册。数据若必须留在自己机器上,Cloud Connect 用认证隧道把本地工作区连到 Cloud,本机继续保有数据、继续跑本地 Agent。
于是多元 Agent 的工作方式可以一句话说清:一个共享的库,一组无状态的 Agent。 研究 Agent 起草,执行 Agent 落地,人审要紧的——大家读同一批记录,把成果留在同一个地方。换 Agent 不再需要知识交接,因为交接一直在发生,就在库里。十个互不共享记忆的 Agent 不是一个团队;一个大家都读写的库,才让它们成团。
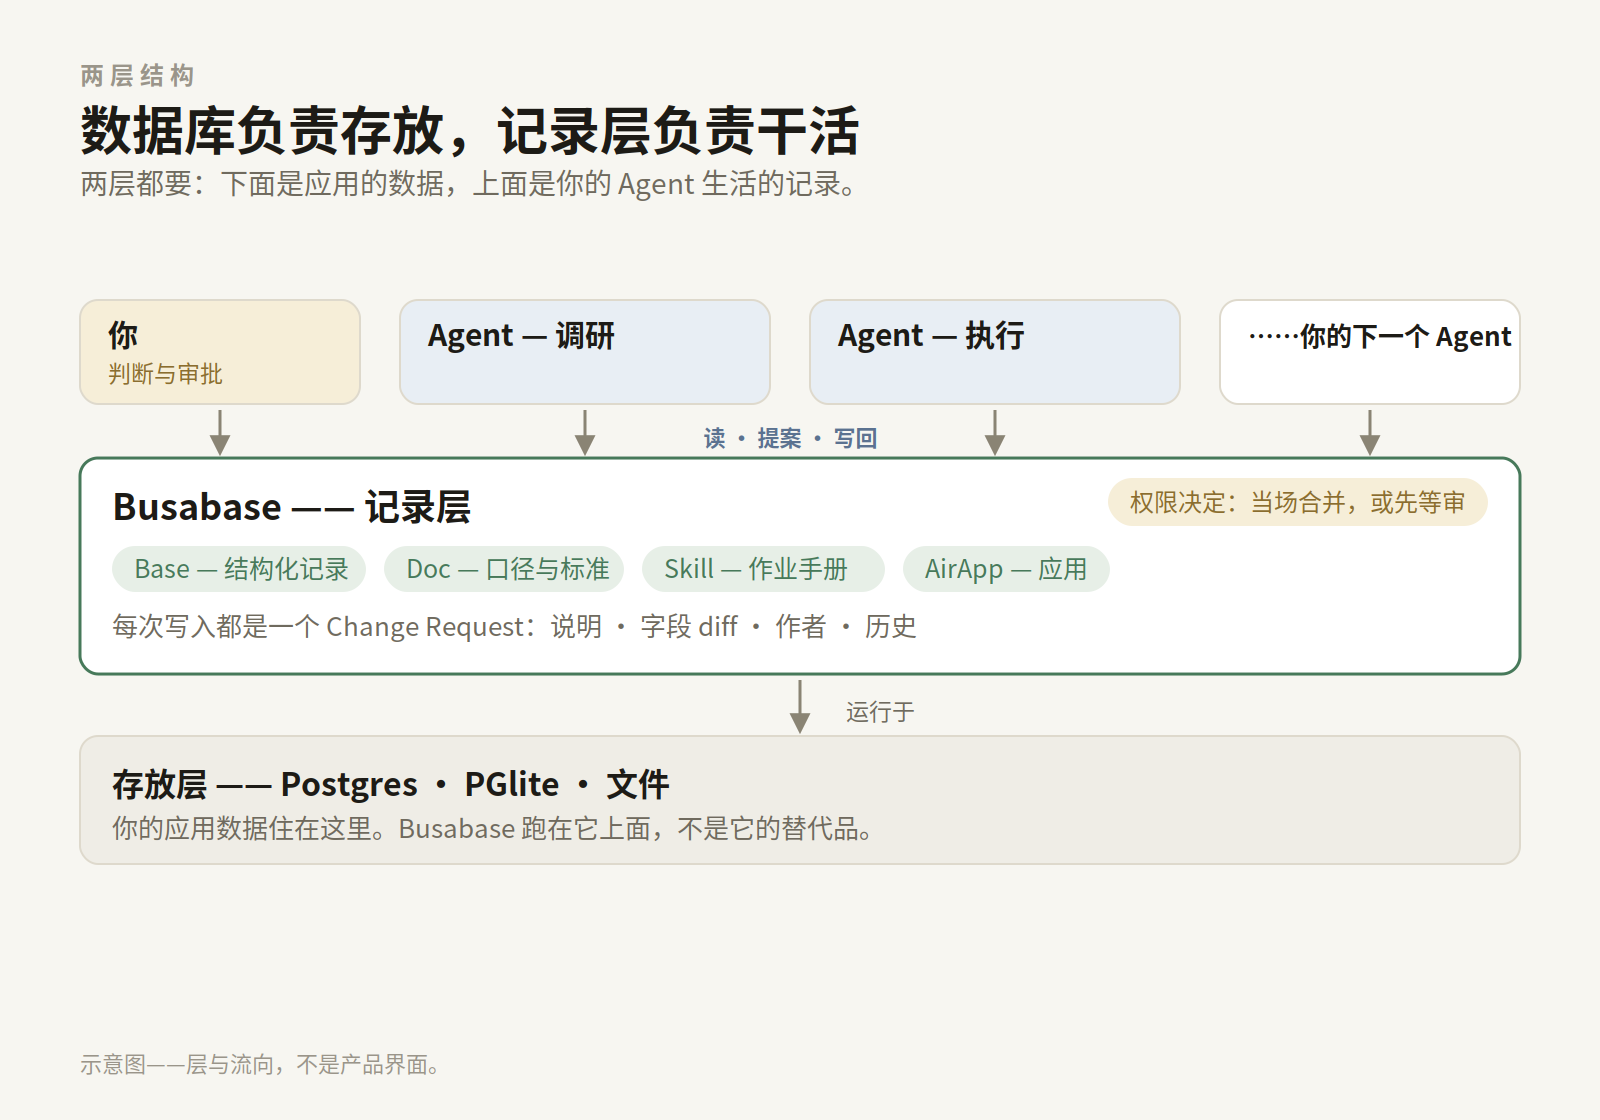 数据库负责存放,记录层负责干活——两层是组合,不是竞争。
什么不该放进你的个人数据库
节目里那些例子——财务、健康、人际关系——恰恰说明个人数据库需要边界,不只是容量:
- 秘密永远不进。 密码、令牌、恢复码不进任何记录。存「东西放在哪」的指针,不要存东西本身。
- 存引用,不存整份拷贝。 合同、病历文件可以链接或以附件形式放在你掌控之下;不要把敏感全文贴进会被 Agent 引用回聊天里的字段。
- 敏感类别要显式划界。 如果你记健康或财务数据,就明确哪些 Agent 能读那几张表,并把这个决定写进「工作口径」Doc。
- 判断权留给人。 钱、承诺、日期,Agent 负责提案,你负责拍板。这个库的职责是让拍板有据可查,而不是把拍板自动化掉。
先放一周的会议进去
不需要立项迁移。装上服务,贴上提示词,把真实的一周放进去:你见过的人、你做过的决定、你纠正过的一条经验。第二周,换一个不是当初搭库的那个 Agent 问它:「上周我们决定了什么?为什么?」它能从库里答出来——能——你就有了 Lightcone 那期所指的那样东西:一个你自己的数据库,而且是你的 Agent 真正能在里面干活的那种。
- 代码与自托管:github.com/busabase/busabase
- 桌面版:busabase.com/download
- 也可以从模板起步:busabase.com/templates
- 文档:busabase.com/docs