别再做 AI 读不了的软件
别再交付 AI 读不了、做完就没意义的软件。Busabase 把 Skill、数据与文档结构化开放给 Agent,并用 Change Request 管住每一次写入。

别再做 AI 读不了的软件。
不是「别写代码」。是别再交付那种——做完只剩给人点的按钮、给人看的页面、给人记的 wiki,下一个 Agent 看不见、读不动,人也渐渐不再用的东西。AI 读不了,人也不用:这份软件,做完就没意义了。
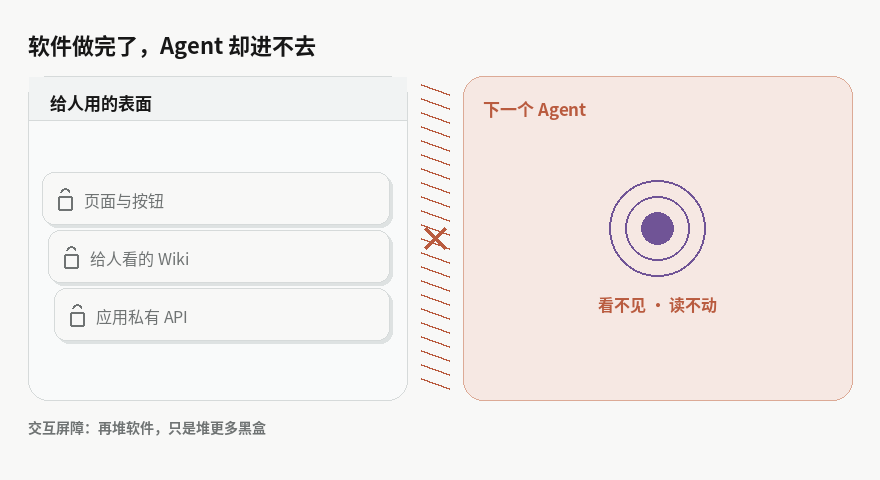
再堆更多这种软件,不是在扩大能力,是在堆黑盒。人被迫当翻译、当搬运工、当「把刚才那页表再念一遍」的接口。那不是产品,是浪费。
我们最近在做软件时,把话说得更冲一点:
别再做 AI 读不了的软件。要做,就开放接口给 Agent——让 AI 去发挥;写入用 Change Request 兜住。这远比只给人堆更多手工 UI 有意义。
UI 当然还要。但它不该是唯一入口。真正值钱的,是系统既能被 Agent 读、也能被写,写完还能被人看懂和兜住。
我觉得,这就是 Busabase 的价值所在。
一个很小的现场感
有一次,Agent 顺着开放的接口往下挖,把一笔支付挖成了「课程充值」——不是猜的,是读到了。旁边有人感叹:接口足够开放,就啥都给你挖出来。
另一句更短:
这就是 Busabase 的价值,随你读。
Change Request 也给你兜底。
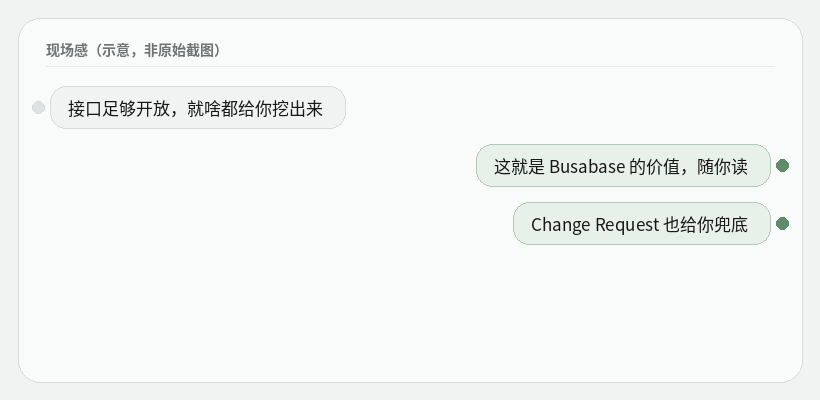
「随你读」说的是开放;「兜底」说的是管控。两件事必须同时成立,Agent 工作区才站得住。
1. 结构化开放:把 Skill、数据库、文档开放给 AI
传统软件的「开放」,常常停在给人用的页面,或者给应用自己用的私有 API。对 Agent 来说,这还不够——读不进去,就等于没做。
Busabase 把工作区做成一棵节点树:Base(有类型的记录、关系、视图)、Doc、File、Drive、Skill、AirApp、白板、工作流……人和不同 Agent 共用同一份结构化数据。官方一句话写得很直白:
The System of Record for AI Agents
面向 AI Agent 的记录系统——不同 Agent,同一个共享底座。
开放,不是把一堆 Markdown 扔进文件夹就算完。它至少包含三层:
数据是结构化的。
记录有字段类型、关系、视图,可以 list、可以 grep、可以按条件查询。Agent 不是在聊天记录里「回想」,而是在一份人和它都能打开、引用、修正的事实库上工作。
知识与操作手册也是结构化的。
Skill 是一级节点:SKILL.md 加上配套文件,挂在工作区里;Playbooks 把它们汇成目录,接入的 Agent 动手前先查「这个空间里这件事该怎么做」。模板装进来的 App,也带着说明书——表是什么意思、字段干什么、什么事不能做——下一个 Agent 读的是同一份手册,而不是你剪贴板里的临时说明。
接入面是给 Agent 设计的。
Agent Skill、MCP、OpenAPI、CLI、SDK……没有内置模型、不绑厂商。Agent 保持无状态,工作留在工作区:读团队和其他 Agent 已经留下的记录、文档、Skill 和应用,再把自己的产出写回去。
我们自己发官网内容时,也在用同一套逻辑:发布流程、字段约定、目标 Base,都住在 Busabase 工作区里——写 Blog Post 走的同样是结构化写入,而不是把文章埋回仓库里的 MDX。内容本身也成了 Agent 下次还能接着读的资产。
接口足够开放,Agent 才能「挖」得出来;结构足够清楚,挖出来的才是可信的事实,而不是幻觉。
这比堆更多手工 UI 更接近「让 AI 发挥」:UI 服务人;结构化接口服务人与 Agent 的协作——也才不会做出「AI 读不了、人也不再用」的软件。
2. 自由与管控并存:权限 + Change Request
只开放、不管控,Agent 会把系统写成不可审计的泥潭;只管控、不开放,又回到「什么都要人点」的老路——还是那堵 AI 读不了的墙。
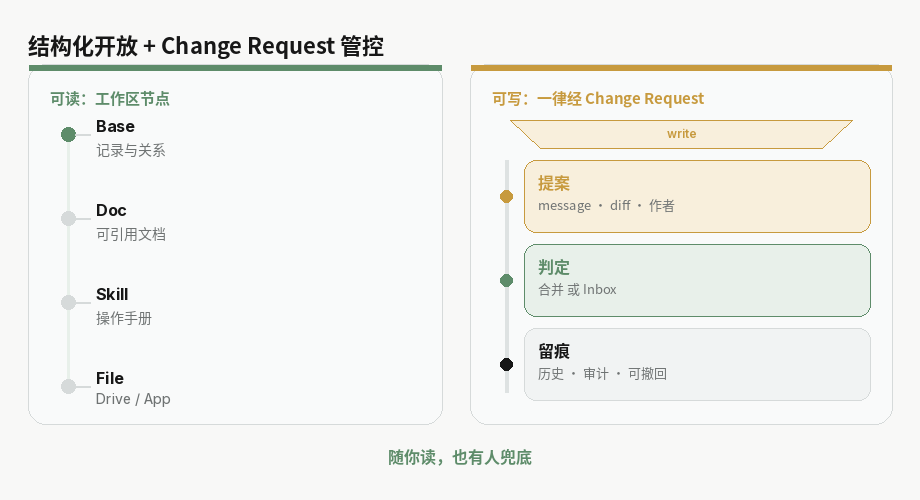
Busabase 的写法是:
Agent 读取工作区上下文
        ↓
Agent 写入数据、文档、Skill 或应用改动——一律以 Change Request 提交
        ↓
由权限决定:当场合并,或进 Inbox 等待审核
        ↓
无论哪种,改动都可查看、可追溯、可撤回
每一次写入都是 Change Request:带说明(message)、字段级 diff、作者,以及历史与审计轨迹。它不是「先偷偷改库,事后补日志」,而是变更本身就是一等公民。
权限决定自由度:
- 有写权限的凭据,改动可以当场合并——照样留下 diff 和历史;
- 上限为
changeRequest的凭据只能提议,进 Inbox; - 单次调用也可以显式要求人看一眼;
- Agent 被要求:不要自己批准还在审核中的 CR——批准是人的决定。
所以「自由」不是无边界乱写,而是:在权限允许的范围内,Agent 可以流畅地读和写;「管控」也不是处处拦路,而是:每笔变更可读、可归责、可回滚,该等人时就等人。
这就是「Change Request 也给你兜底」的产品含义——开放让 Agent 能干事,Change Request 让干完的事还能被人和下一个 Agent 看懂、审过、收回。
它和传统数据库的区别
传统数据库,真的就是数据库。
Postgres、MySQL 很强,但它们为应用读写存储而生:没有面向 Agent 的工作区模型,没有共享 Skill,没有「提议边界」,也没有把 message / diff / 作者 / 审核织进每一次写入的默认路径。Airtable、Notion 一类工具为人直接编辑设计得很好,可一旦主力变成 Agent,缺的往往正是:原生的 Agent 接入、共享的操作手册,以及可审的提议层。
向量库和「Agent 记忆」解决的是单个 Agent 怎么回想上下文;它们通常给不出一份人能打开、引用、当场改对的结构化事实。
Busabase 自己也跑在 Postgres(或内嵌 PGlite)上——它不是要替换你应用里的库,而是在上面做一层 人和 Agent 共建的工作区:结构化开放给读,Change Request 管住写。
一句话:
传统数据库不是为 Agent 设计的;Busabase 是。
所以,软件还要不要做?
要——但别再做 AI 读不了的那种。
做软件的重心,要从「给人多做几个只能点的页面」,挪到「给 Agent 多开几扇能读的门,同时把门上的锁和审计装好」。做完还能被 AI 读到、写回、审过——这样软件才不会在 Agent 时代变成新的屏障,也不会在人不再当翻译之后立刻失去意义。
接口足够开放,就真的能把「课程充值」这种细节挖出来;Change Request 足够完整,挖完、改完,也还有人能兜住。
别再做 AI 读不了的软件。随你读,也有人兜底。
这就是 Busabase 想守住的那一点价值。
常见问题
不是。Busabase 可以跑在 Postgres / PGlite 上,目标不是替换业务库,而是提供人和 Agent 共用的结构化工作区:记录、文档、Skill、应用,以及每一次写入的 Change Request。
会。所以 Busabase 把写入做成 Change Request:有权限可当场合并(仍留 diff),权限不够就进 Inbox。开放解决「读得见、写得进」;管控解决「写得清、收得回」。
向量库和会话记忆帮助单个 Agent 回想上下文。Busabase 要的是人和多个 Agent 能打开、引用、修正的同一份结构化事实,以及可审的写入路径——更接近 System of Record,而不是私有记忆。