
让 Agent 起草内容,再由编辑审核,看起来已经是一条完整的生产流程。但网站接入后,团队还要回答另一组问题:网站读取哪一版?批准后是否立即公开?页面没刷新时,是稿件没合并,还是缓存没有更新?
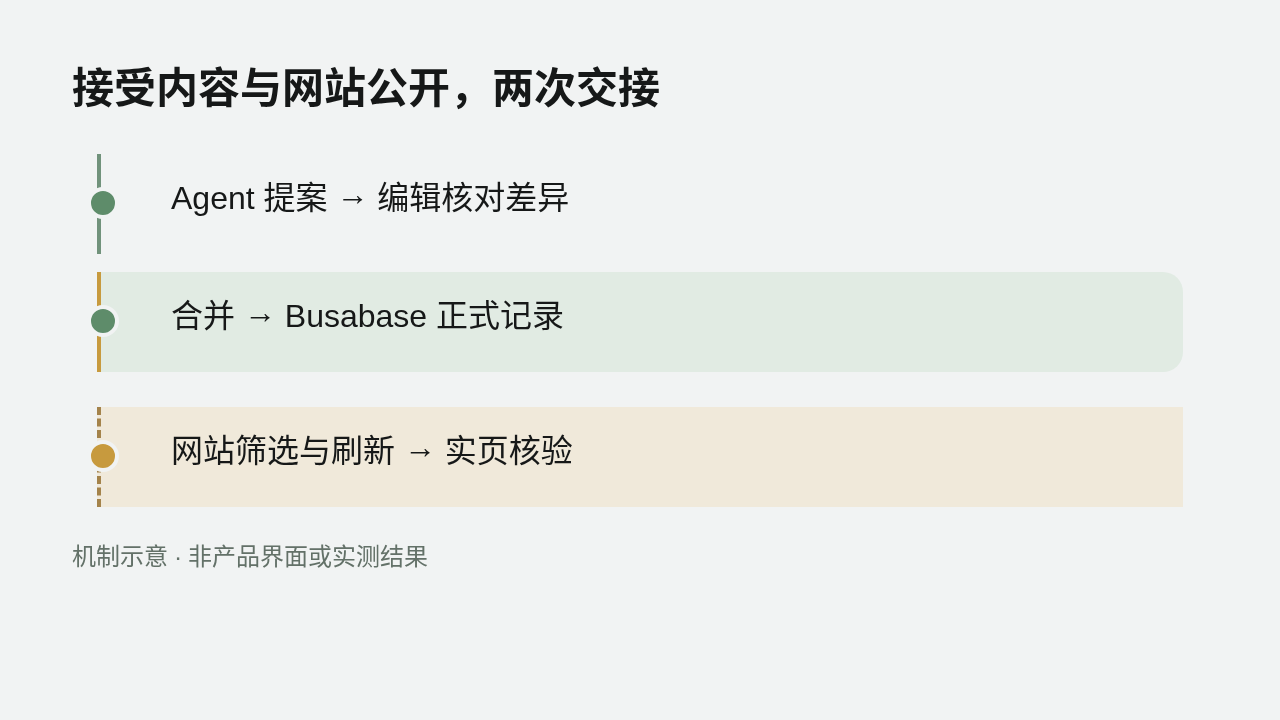
内容接受与网站发布需要分别定义。前者决定什么进入可信记录,后者决定访客能看见什么。两条链路接对了,编辑才能知道自己的操作会产生什么结果。
先确认网站究竟在读取什么
在 Busabase 中,编辑通过 ChangeRequest 保留提案和修改历史。待审变更、已批准变更、已合并的记录,分别处于不同阶段。合并会推进记录指针,让接受后的版本成为 canonical 记录;批准动作本身并不等同于这一推进已经发生。
网站集成应该明确读取入口。对外页面通常应消费已接受的 canonical 记录,并按网站自己定义的公开条件筛选。待审提案可以进入专门的预览入口,但不应混入面向访客的读取集合。
这里的公开条件需要由具体 CMS 和网站实现。例如团队可以约定,记录合并且满足已定义的发布状态和时间后,才进入站点消费范围。这个约定不是 Busabase 自动替所有网站设置的发布规则。
审核有没有生效,取决于权限配置
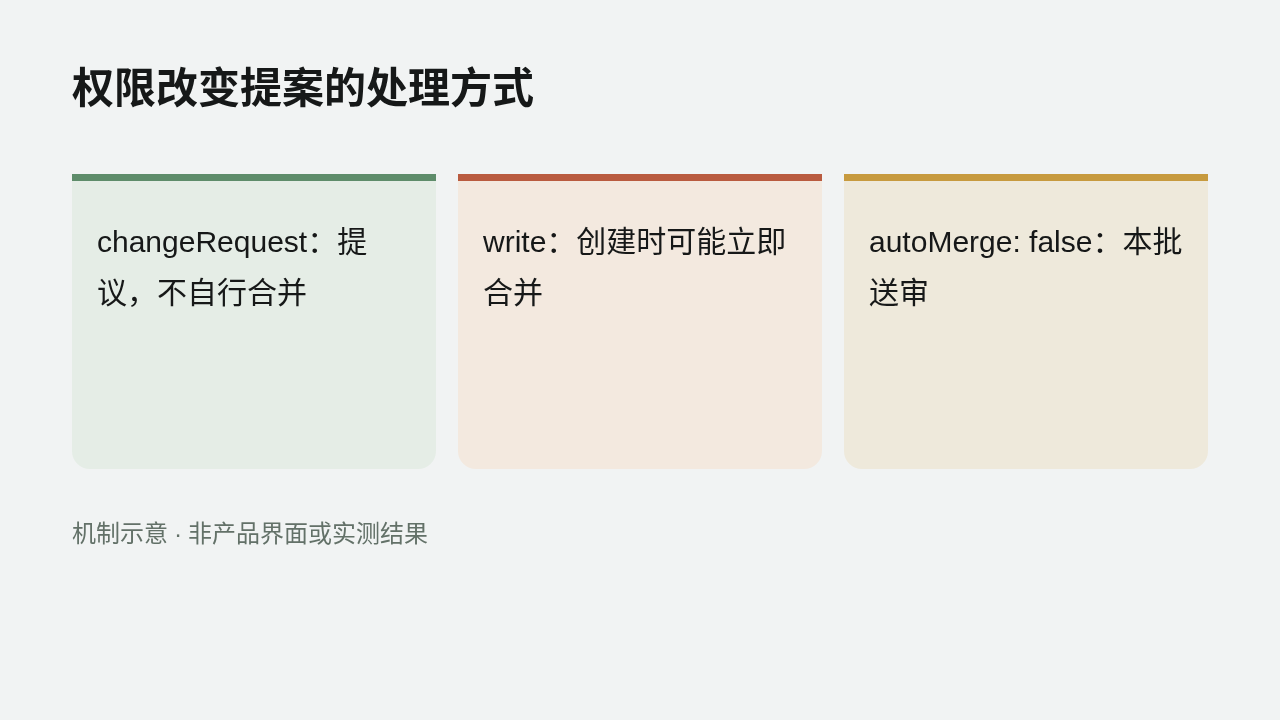
API key 权限会改变提案的处理方式。changeRequest 权限允许读取与提议修改,但不能合并自己的提案。持有 write 权限的写入方,创建 ChangeRequest 时可能立即合并;调用方也可以显式设置 autoMerge: false,让该批变更进入审核。
因此,“接了 ChangeRequest”还不足以证明存在人工闸门。团队需要确认实际凭据的权限、提交参数,以及返回的真实状态。
如果内容必须先由编辑接受,给起草 Agent 配置 proposal-only 凭据,比要求它每次自觉停住更清晰。站点读取凭据则按任务配置必要的读取权限。凭据应留在服务端,不能出现在公开页面或浏览器代码里。
审核一条记录,要看完整的公开单元
正文通过了,摘要却还在承诺旧能力;中文已改,另一语言仍保留错误价格;链接文字正常,目标却已失效。这些都说明审核对象不应只有正文。
把标题、摘要、正文、封面、正文图、链接和语言版本作为同一个公开单元核对。跨语言内容需要保留对应关系,明确哪些版本可以一起接受,哪些需要单独等待。
对更新稿,还要查看修改前后的差异和适用范围。编辑认可某个段落,并不自动批准 Agent 顺便改动发布日期、路由或其他文章。提案消息与变更范围应让审核人看得见这次会影响哪些页面。
从记录合并到访客可见,中间还有交付
一个实用的网站消费契约,应说明以下内容:
- 读取对象: 哪个 Base、哪些记录、哪个 canonical 版本以及哪些公开条件。
- 预览方式: 未公开版本在哪里核对,预览是否与生产使用同一种渲染规则。
- 刷新机制: 合并后由构建、缓存失效或其他受控机制刷新,以及失败如何被发现。
- 验收对象: 实际页面正文、语言路由、图片、链接和公开元数据。
- 撤回处理: 停止公开后如何清理页面、缓存及相关入口。
这些是建议的集成约定,需要网站维护者落实。不要把某个新增记录事件泛化成所有内容更新的通知;选择事件或轮询机制时,要核对它是否覆盖更新、状态变化和撤回。
发布失败,先确定停在哪一段
当编辑说“批准了,网站怎么没变”,先查 ChangeRequest 是否已经合并,再确认站点读到的记录版本。若 canonical 已正确,继续查公开筛选条件、构建与缓存刷新。若生产页仍旧,保留实际响应和页面版本,避免再次创建相同稿件来试图触发发布。
重试也要分层:内容已合并时,重试下游刷新;内容仍待审时,处理审核;版本冲突时,回到提案核对。把所有失败统一处理为“再写一遍”,容易制造重复记录。
撤回同样需要完整验收。修改记录的公开状态后,检查页面、列表与其他已配置入口是否按站点约定更新。历史提交仍应留在审计中,方便解释此前公开过什么。
用 Busabase 组织一次从起草到上线的交接
已有 CMS Base 就复用,不另建一套文章库。若从零开始,可以用 Folder 归组资源,用一个 Base 保存文章:标题、摘要、正文、语言、公开条件和预览入口;用 Doc 保存编辑与公开规则,用 Skill 保存 Agent 每次起草前要执行的方法。这些字段是建议设计,实际名称和状态值应与网站读取逻辑一致。多语言可用关联字段连接对应版本,原始来源也要有可追溯入口。
Agent 读取规则和来源后,对指定文章提交 ChangeRequest,提案中列清受影响的字段和语言。编辑在变更中核对差异;只有合并后,接受的内容才成为正式记录。网站服务端读取这个 Base 的正式记录,再按约定的公开条件筛选并刷新页面。把生产 URL 与页面核验结果写回对应文章,团队就能从同一条记录查到原稿、接受的版本和实际页面;待审提案留在预览中。网站读取、刷新及结果回写需要具体集成实现。
用一类内容跑通完整闭环
在 Content Factory 中,可以把来源、稿件与审核记录组织起来,再由既有网站消费已接受的内容。先选一种内容类型,明确 Agent 的提案权限、编辑接受范围和站点读取契约,之后再扩展自动化。
给内容 Agent 的指令可以从这里开始:
读取指定来源和编辑规则,准备完整的标题、摘要、正文及链接,检查现有记录避免重复。通过 ChangeRequest 提议修改,并说明影响的页面和语言版本。将返回状态与预览入口交给编辑;不要把待审状态写成已发布。
给网站维护者的验收则关注另一件事:用一份待审修改、一份已接受修改和一次撤回,分别检查预览、canonical 读取和生产页面是否符合约定。这是建议的验证方法,实际结果应由具体站点执行后记录。
AI 审核瓶颈关心的是人如何高效审阅。到了网站交付阶段,还需要让“编辑接受了什么”和“访客看见什么”各自可查。两者的连接明确,内容团队才能放心增加 Agent 的执行量。