主权 AI 的最后一公里:模型私有化之后,Agent 干出来的活儿留在哪?
在内网跑起开源大模型只是第一步。真正的主权 AI 是让 Agent 保持无状态,把结构化数据、Playbooks 技能、离线可验签的运行环境以及重要写入的终审权留在自己的物理边界内。

谈论**主权 AI(Sovereign AI)**时,大多数团队的第一反应都是买显卡、搭集群,把 DeepSeek、Qwen 或 Llama 等开源权重模型部署进自己的内网机房。似乎只要模型跑在防火墙里面,AI 主权就大功告成了。
但半年之后,真正要让业务跑起来时,团队往往会撞上一堵无形的墙:模型确实在内网,但活儿却干不起来。
员工依然把敏感的客户资料复制粘贴进个人的聊天窗口;Agent 每次新开会话都从零开始;业务 SOP 被锁在某位工程师的本地提示词文件里,或者散落在外部公有云 SaaS 文档中。更棘手的是,当有人提议让 Agent 直接写生产数据库时,安全与合规部门会立刻叫停——因为没人能说清 Agent 会在什么时候覆写哪条关键记录,也没人敢为机器速度下的幻觉背锅。
这就是主权 AI 落地的「最后一公里」困境。MIT NANDA 项目在企业生成式 AI 调研中发现,高达 95% 的 AI 试点未能带来可衡量的业务回报;问题不在于大模型不够聪明,而在于上下文与学习断层——通用工具既不会沉淀一家公司独特的做事方式,也无法让产出变成受控的组织资产。
把模型权重搬进内网,只解决了推理主权(Inference Sovereignty)。要让主权 AI 在业务现场真正跑通,你还需要工作区主权(Workspace Sovereignty):把结构化数据、可复用技能、运行边界,以及决定「什么才算数」的人类终审权,完整留在自己的物理边界内。
为什么「只有模型私有化」在生产环境里走不通
大语言模型天生是无状态的:输入 Token,输出 Token,然后遗忘。真正让 AI Agent 随时间产生复利的——客户台账、项目上下文、标准作业程序(SOP)以及审批状态——全部存在于模型权重之外。
当企业只投资了私有推理,却没有为 Agent 准备一个受控的自托管工作区时,四个落地断层会立刻暴露出来:
| 层级 | 「仅模型私有化」的做法 | 在真实业务中的失效方式 |
|---|---|---|
| 模型推理 | 在内网或专有云部署开源大模型 | 解决了算力与推理隐私,但跨会话没有共享状态,每次对话从零开始 |
| 上下文与记录 | 业务表格和文档仍放在外部公有云 SaaS,或留在个人聊天框里 | 要么业务上下文被迫出域,要么 Agent 的最佳产出死在个人对话框里 |
| 技能与流程 | 把提示词和工作流硬编码进单一厂商的平台或个人脚本 | 团队被锁死在特定工具上;一旦更换底层模型,所有工作流推倒重来 |
| 数据库写入 | 给 Agent 配一个服务账号,直接开放数据库 INSERT / UPDATE | Agent 以机器速度静默覆写数据,没有字段级 Diff、没有人工审核、无法追责 |
如果模型跑在你的机房里,但团队的业务知识被锁在外部厂商的私有记忆里,或者 Agent 写下的数据没人敢直接引用,你拥有的并不是主权 AI,只是一个「内网聊天框」。
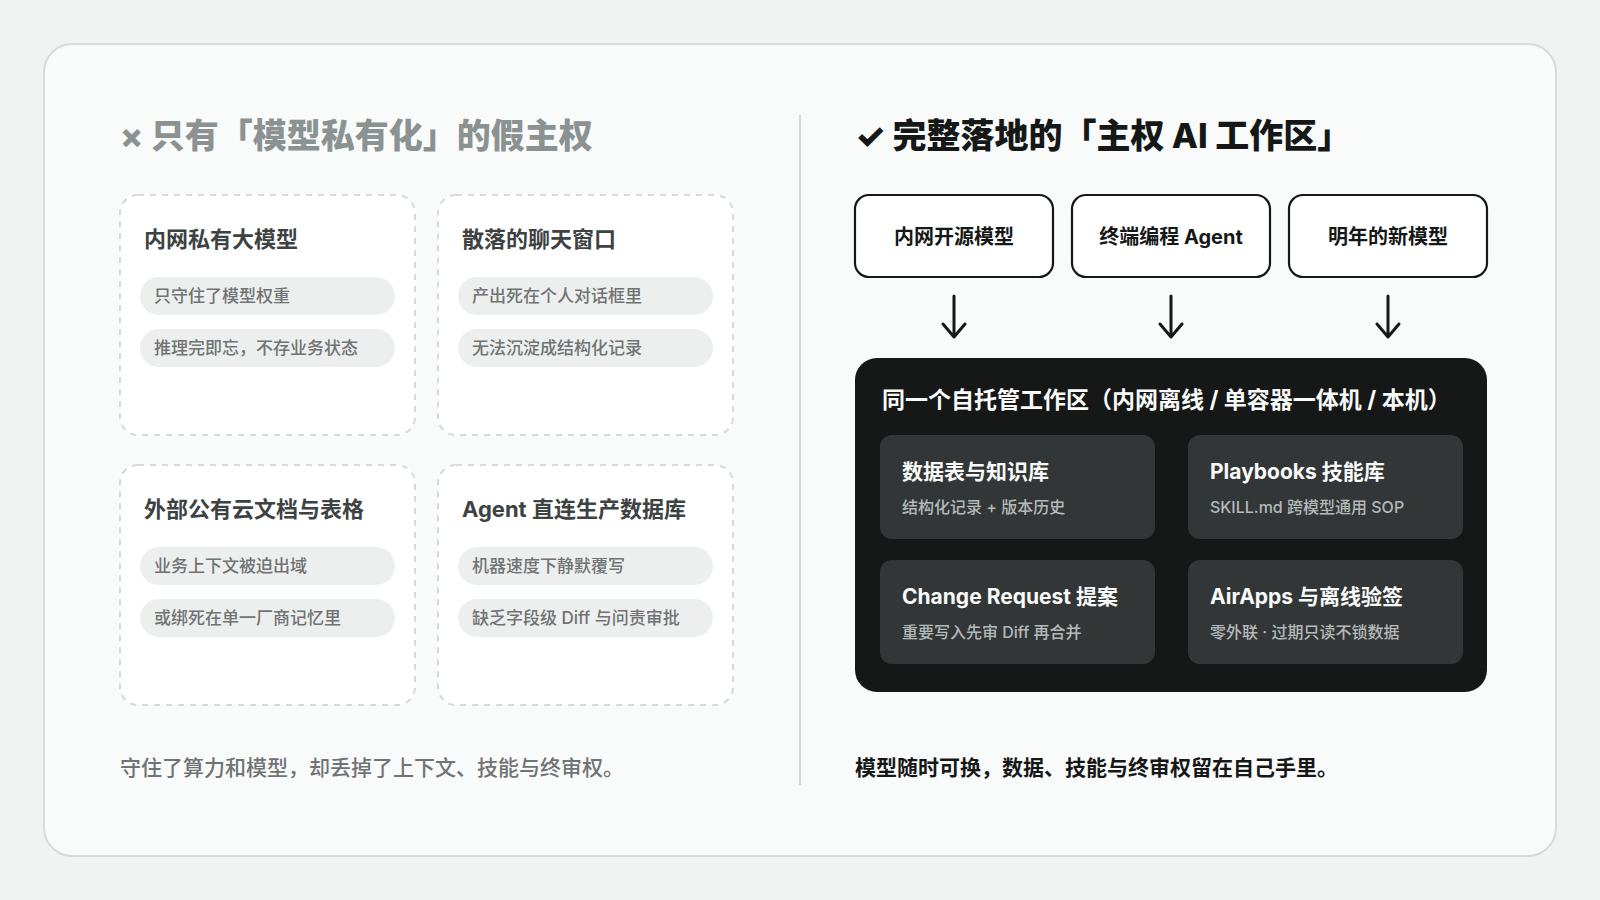
要打通这最后一公里,主权必须从模型层延伸到人与 Agent 共同干活的工作区层。
第一重主权:模型独立——让 Agent 无状态,把技能留在工作区
真正的主权首先意味着不被任何单一模型或工具绑架。大模型迭代极快,不同任务往往需要不同的客户端:处理高敏合规数据用内网私有大模型,写代码用 Claude Code 或 Codex,在编辑器里用 Cursor 或 OpenCode,或者接入自建的 DeepSeek Harness。
如果每个 Agent 都把记忆和技能藏在自己的客户端里,每换一次模型,团队积累的经验就会清零。正如我们在《如何让 AI 在团队里真正用起来》中所总结的:让 Agent 无状态,把记忆交给团队。
在 Busabase 中,这一原则直接体现在架构设计上:
- 结构化数据表(Bases)与文档(Docs):存放所有 Agent 行动前必须读取的业务事实与背景资料。
- Playbooks 技能库(
SKILL.md与自定义提示词):作为一等公民节点保存在工作区中。无论你用哪个 Agent 连接 Busabase,它执行任务的第一步都是检索工作区的 Playbooks 目录,按团队统一的 SOP 办事。 - AirApps 原生应用:直接构建在工作区实时数据之上,为人类提供干净的业务操作台(如 CRM、内容审校台、工单面板),且自带说明文档供下一个 Agent 读取。
- 开放接入协议(MCP、OpenAPI、CLI、Agent Skill):不绑定任何内置模型。无论你的 Agent 走 MCP 协议还是调
/api/v1REST 接口,工作区契约始终一致。
当你把内网模型从上一代升级到下一代,或者让不同部门使用各自顺手的编程 Agent 时,业务流程一行都不用重写。新 Agent 连上同一个 Busabase,读同一份 SKILL.md,在上一任 Agent 停下的地方继续往下做。
第二重主权:物理与运维主权——从个人本机到内网完全离线
数据主权不能只停留在合同条款上,它取决于你的部署边界。一个必须时刻连接厂商公有云控制面才能启动的工作区,进不了隔离实验室、金融核心网或断网研发环境。
Busabase 基于统一的开源核心引擎(busabase-core),可以在不同主权等级的环境中平滑运行,且保持完全一致的 API 与数据语义:
| 主权部署等级 | 运行方式 | 适用场景 | 运维与资源边界 |
|---|---|---|---|
| 本机与个人版 | npx busabase server 或 Busabase 桌面版(内嵌 PGlite + 本地磁盘) | 个人开发者、本地 Agent、完全离线办公 | 零配置启动,MIT 开源免费,数据全程留在自己电脑里 |
| 自托管单机一体机 | 单个容器(busabase/busabase-premium-allinone),内置真实 Postgres 与对象存储 | 20 人以内高敏团队、POC 验证、内网隔离网段 | 冷启动约 24 秒,空载内存约 548 MiB,仅需挂载一个 -v busabase-data:/data 卷 |
| 生产级 Compose 与 K8s | Docker Compose 或 Helm Chart,对接企业自有 PostgreSQL、Redis 与 S3/SeaweedFS | 20–500+ 人正式生产环境、高可用与横向扩容 | 完全纳入企业自有 DBA 与 SRE 备份、监控与灾备体系 |
| 本地到云端混合隧道 | 本地实例通过自托管隧道(Self-Hosted Tunnel)挂载至 Busabase Cloud | 核心数据物理留在本机,同时需要跨组织协作 | 原始数据不离开本地磁盘,在云端空间列表中作为平级空间协同 |
对于严格的内网私有化与离线安装环境,工程上的真正自主体现在三个细节里:
- 零外联(Zero Phone-Home):自托管的 Busabase 实例没有任何一处需要「回家报到」。在联网机器上把约 489 MB 的一体机镜像
docker save成 tar 包,校验 SHA-256 哈希后搬进物理隔离内网docker load,在一台从未连过外网的机器上跑起来和联网环境完全一样。 - 本地公钥离线验签:商业自建版的授权激活是「粘贴」,不是「请求」。系统对着编译进构建里的公钥在本机完成签名核验,没有任何流量离开这台机器。
- 过期转只读,绝不锁死数据:主权的底线是你的数据永远不会被软件供应商扣作人质。即便商业授权到期,自建实例也只是平顺地转为只读模式——暂停写入,但所有历史记录、文档、技能和数据导出依然随时可用。
第三重主权:治理与问责主权——由人类决定「什么才算数」
到了 2026 年,企业 AI 治理面临的最严苛拷问早已不是「数据库放在哪个机房」,而是监管与业务负责人提出的这个问题:「当一个自主运行的 Agent 修改了这条核心业务记录,是谁授权的?依据是什么?能不能拿出变更前后的证据?」
传统的权限系统只管「能不能写(Permission)」。但正如我们在《Agent 写进去的数据,凭什么算数?》中分析的,有写入权限不代表结果权威。一个拥有写权限的 Agent,依然可能在几秒钟内因为幻觉改错合同到期日、覆盖合规状态或污染商品目录。
Busabase 在写入边界上把治理主权落成了原生工作流:
Agent 读取工作区上下文与 Playbooks 技能
        ↓
Agent 发起写入 → 自动生成 Change Request(附带说明、字段级 Diff 与作者身份)
        ↓
按权限策略分流:高信任操作当场合并,重要写入停在 Inbox 等待人工审核
        ↓
人类一键批准 → 合并为权威(Canonical)记录,留下不可篡改的 Commit 与审计历史
- 按风险分级管控:对于常规低风险更新,拥有
write权限的 Agent 可以当场合并,同时在底层完整保留每一次 Commit 差异;而对于关键业务写入(修改客户合同、发布对外页面、变更共享技能),可以将凭证限制在changeRequest级别或指定autoMerge: false,让改动稳稳停在收件箱(Inbox)里,由对结果负责的人类逐字段审阅 Diff 后再批准生效。 - 天然可审计的来历(Provenance):每一条权威记录都带着完整的提交链——哪个 Agent 提议的、改了哪几个字段、修改前后的值分别是什么、哪位审核人批准合并的。面对合规检查或故障复盘,直接打开记录的历史面板就能看清来龙去脉。
这正是把普通数据库升级为 AI Agent 的记录系统(System of Record for AI Agents)的关键:不是把 Agent 挡在门外,而是在「Agent 的提议」与「组织的正式事实」之间,放上一道可审阅、可追责、可回滚的阀门。
主权 AI 落地自检:给技术与业务负责人的四个问题
在评估或验收团队的私有化 AI 架构时,不妨用这四个问题做一次压力测试:
- 如果下个季度我们要换掉当前的主力大模型,有多少东西要重做? 如果提示词、业务规则和上下文绑死在模型厂商自带的平台里,你的切换成本就是推倒重来。
- 聊天结束之后,Agent 干出来的活儿留在哪? 如果答案是「留在聊天记录里」或「靠人工复制粘贴到别的表里」,Agent 就还没有真正进入你的生产主干。
- 拔掉外网网线,整套工作流还能正常跑、正常验权吗? 检查你的工作区、技能库和授权机制是否真正支持零外联运行。
- 半年之后审计查账,你能证明某条记录是哪个 Agent 改的、谁批准的吗? 检查每一次重要写入是否在记录本身留下了字段级 Diff 与审核轨迹。
从你自己的机器开始
Busabase 是面向 AI Agent 的开源数据库与工作区——Agent 和人共用同一份结构化数据、文档、技能与应用,重要写入经审核成为可信记录。
只需不到一分钟,你就可以在自己的电脑上跑起完整的主权工作流:
npx busabase server
或者根据你的安全边界选择部署形态:
- 个人与完全离线办公:下载 Busabase 桌面版,或直接使用 MIT 开源版在本地运行。
- 团队内网自建与物理隔离环境:阅读自建 Busabase 概览与内网离线安装指南。
- 多团队云端协同:免费开始使用 Busabase Cloud,需要时随时通过安全隧道挂载你的本地实例。