停止被 Agent 平台绑架吧
Claude Code、Codex、Grok、Cursor、Copilot、Devin、Manus——你每用一个 Agent,它就替你攒下一份家底,锁在自己的抽屉里:它记下的、它跑过的、你的工作数据。把 Skill、应用代码、数据库和结构化上下文搬进一个属于你的池子,Agent 才变回它本该是的样子:一只随时能换的手。

周一早上,你在教同一件工作——第四遍了。
第一个 Agent 把你的偏好学得很好,可它记下的笔记只躺在你这台机器上它自己的记忆文件里,格式也是它自己的。第二个把整个流程放自家云端跑,跑得漂亮,但那段历史只存在于那个账号、那个产品里,别处打不开。第三个记住的又是另一块,还只认它那一个工作区。现在第四个打开在你面前——本季度公认的升级款——它什么都不知道。空白对话框。你又从头讲起。
这背后没有什么阴谋。每个 Agent 都是照着自己的设计在做事:把学到的东西留在身边,你才会回来。但你工作的家底,如今摊在什么地方?你的偏好,存在一家厂商的记忆库里;你的任务历史,存在另一家的云端;你团队的规矩,被写了三遍,三种方言,三套目录约定。绑架你的从来不是模型——模型随时能换,你也一直在换。被扣作人质的,是你的数据,一格抽屉一格抽屉地,扣在别人手里。
绑架是怎么发生的:三格抽屉
先把话说准。这个行业并不是铁板一块地封闭——把问题说准,比喊口号重要。
第一格:你亲手写的文件。 Claude Code 读 CLAUDE.md(也读 AGENTS.md);Codex 读 AGENTS.md,有它自己的分层与上限;Cursor 读 .cursor/rules/*.mdc,有一套自己的 frontmatter 触发语义;Copilot 读 .github/copilot-instructions.md。这些都是本地文件,大多躺在你的仓库里,是你所有家底里最可移植的一层。但可移植不等于共享:每家选的名字不同、目录不同、格式不同、加载规则不同,你写给一个 Agent 的说明,搬给另一个就是一次翻译。
第二格:平台替你攒下的东西。 这一层不是你写的,你也打包不走。Claude Code 的 Auto memory——它根据你的纠正和偏好自己记的笔记——只存放在一台机器上它自己的项目目录里,格式别家不认。Codex 也有同样的机制(需手动开启),OpenAI 自己的文档把产物称作「生成状态」,放在 ~/.codex/memories/,只供 Codex 自己召回;甚至在 OpenAI 自家屋檐下,ChatGPT 的记忆和 Codex 的记忆都是两套独立的存储。GitHub 的 Copilot Memory 存在 GitHub 平台侧,只有 Copilot 自家的几个功能面能读,而且按其概念文档,不被使用的条目 28 天后自动删除。Grok 把整套安排都放在你的 xAI 账号云端:聊天历史、学到的偏好、个性化,跨它的各个 App 同步,能导出的只有一份整账号的数据下载。Devin 的云端会话、Playbooks 和组织知识住在 Cognition 的平台里——当 Cognition 把 Knowledge 功能弃用时,用户攒下的笔记按厂商的时间表、由厂商决定迁走。Manus 在它自己的云沙箱里跑你的任务,会话记录和产出存在你的 Manus 账号里;经它的 API 上传的文件,48 小时后自动删除。
第三格:工作本身。 在指令和记忆之下,躺着真正要紧的东西:工作的记录——线索和它们的状态、任务和负责人、草稿、审批、结果。当一个 Agent 在自己的平台里干完一件活,这份状态就生在平台里面:一段会话实录、一份任务列表、一个沙箱文件系统。你离开时,能带走的只有那份实录;可查询、结构化、还活着的状态,留在原地,或者直接蒸发。
三格抽屉的共同点不是恶意。是每个平台都是一个地方,而你的工作,攒在 Agent 恰好住着的那个地方。换 Agent,你失去的不是模型,是积累。
七家平台,一张表看清
| Agent | 它替你攒下什么 | 存在哪里 | 什么带不走 |
|---|---|---|---|
| Claude Code | 你写的 CLAUDE.md;它自己写的 Auto memory;.claude/ 里的技能与规则 | 你的仓库与本机 ~/.claude/;Web 会话在 Anthropic 账号 | Auto memory——只在本机、自有格式、别家读不了 |
| Codex | AGENTS.md;需开启的 Memories(过往聊天摘要);云端任务历史 | 仓库与 ~/.codex/;云任务在 ChatGPT 账号 | Memories——只有 Codex 能读的「生成状态」,连 ChatGPT 的记忆都不互通 |
| Grok | 聊天历史、学到的偏好、个性化 | xAI 账号云端 | 除整账号下载外的一切;记忆靠删对话来管理 |
| Cursor | .cursor/rules/*.mdc;用户规则;团队规则 | 仓库;本机(用户规则文件按其文档:无同步);团队规则在 Cursor 面板 | .mdc 的触发语义——别家不认这套 frontmatter |
| GitHub Copilot | .github/copilot-instructions.md;Copilot Memory(学到的仓库事实与偏好) | 仓库;Memory 在 GitHub 平台侧 | Memory——只有 Copilot 能读,未使用条目 28 天过期 |
| Devin | 云端会话;Playbooks;仓库里的 Skills;(Knowledge 已被厂商弃用) | Cognition 平台;Skills 在仓库 | 会话与 Playbooks——平台资产,生死由厂商的生命周期决定 |
| Manus | 任务实录、产出、上传文件 | Manus 云沙箱与你的账号 | 工作状态——沙箱会重置;API 上传文件 48 小时删除 |
先说一句公道话:文件这一层,确实在收敛。AGENTS.md 如今是由 Linux 基金会旗下 Agentic AI Foundation 托管的开放格式,Codex、Cursor、Copilot、Devin 都读;SKILL.md 这个 Agent Skills 格式也一样被广泛采用。**你亲手写的东西,越来越能搬家;平台替你攒的,还不能。**抽屉还在,工作还住在抽屉里——这才是本文要打的那一拳,请别把它误读成「所有平台全封闭」。
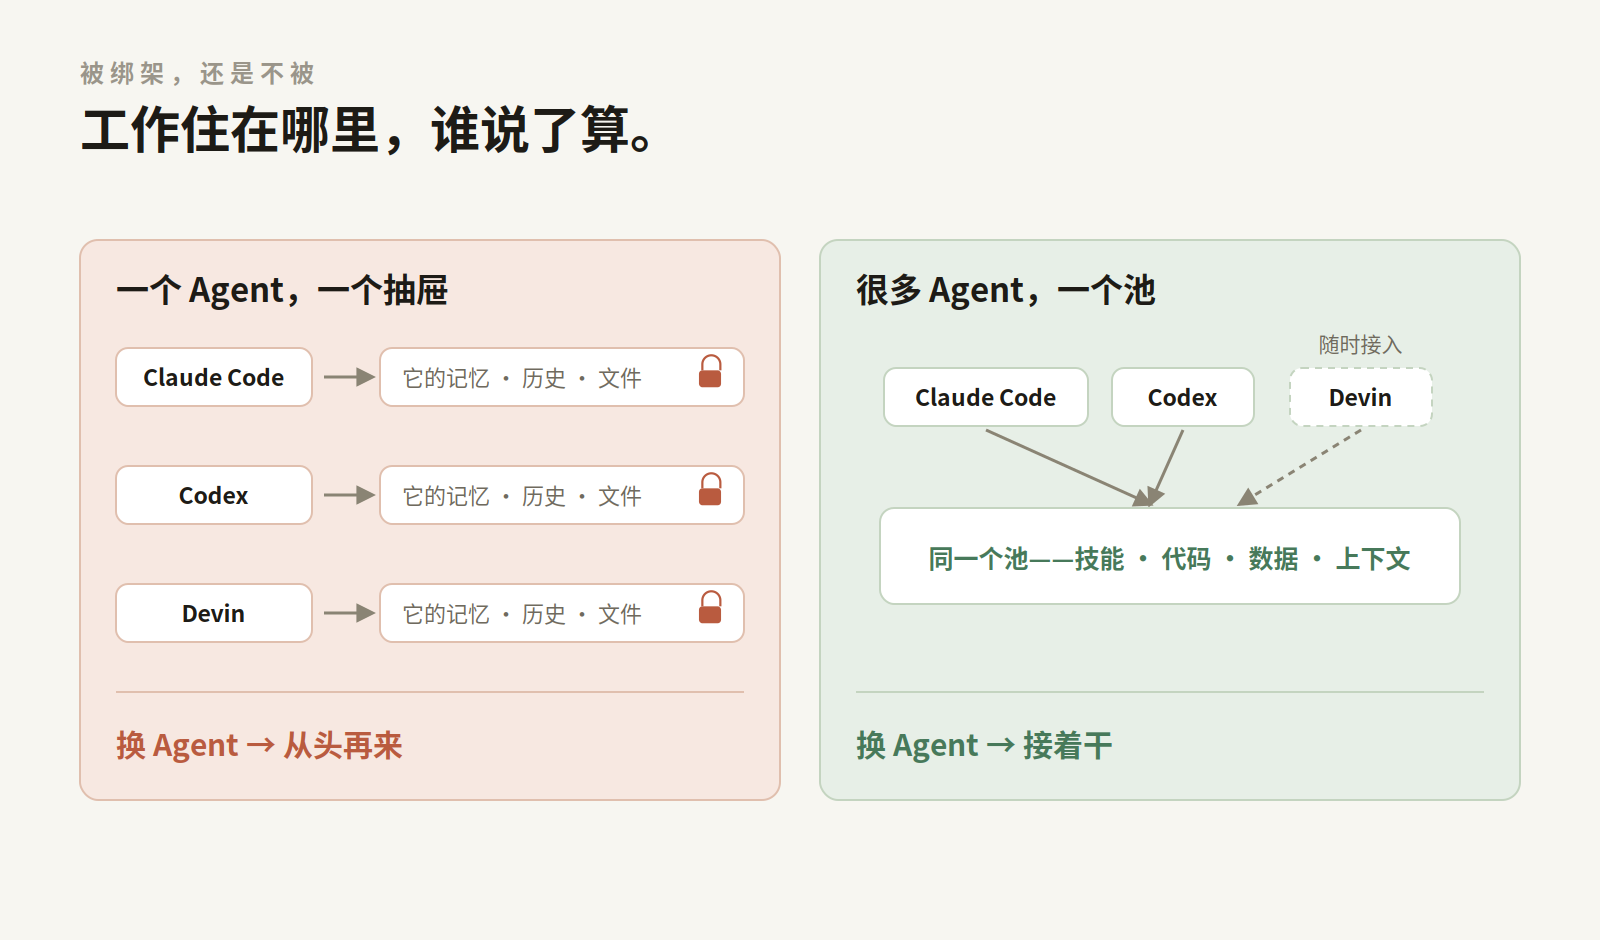
示意图——同一个问题的两种答案:工作住在哪里?
解法,一张图讲完
不要再让每个 Agent 当那个「地方」。把地方放到你自己这边,让所有 Agent 来访问它。
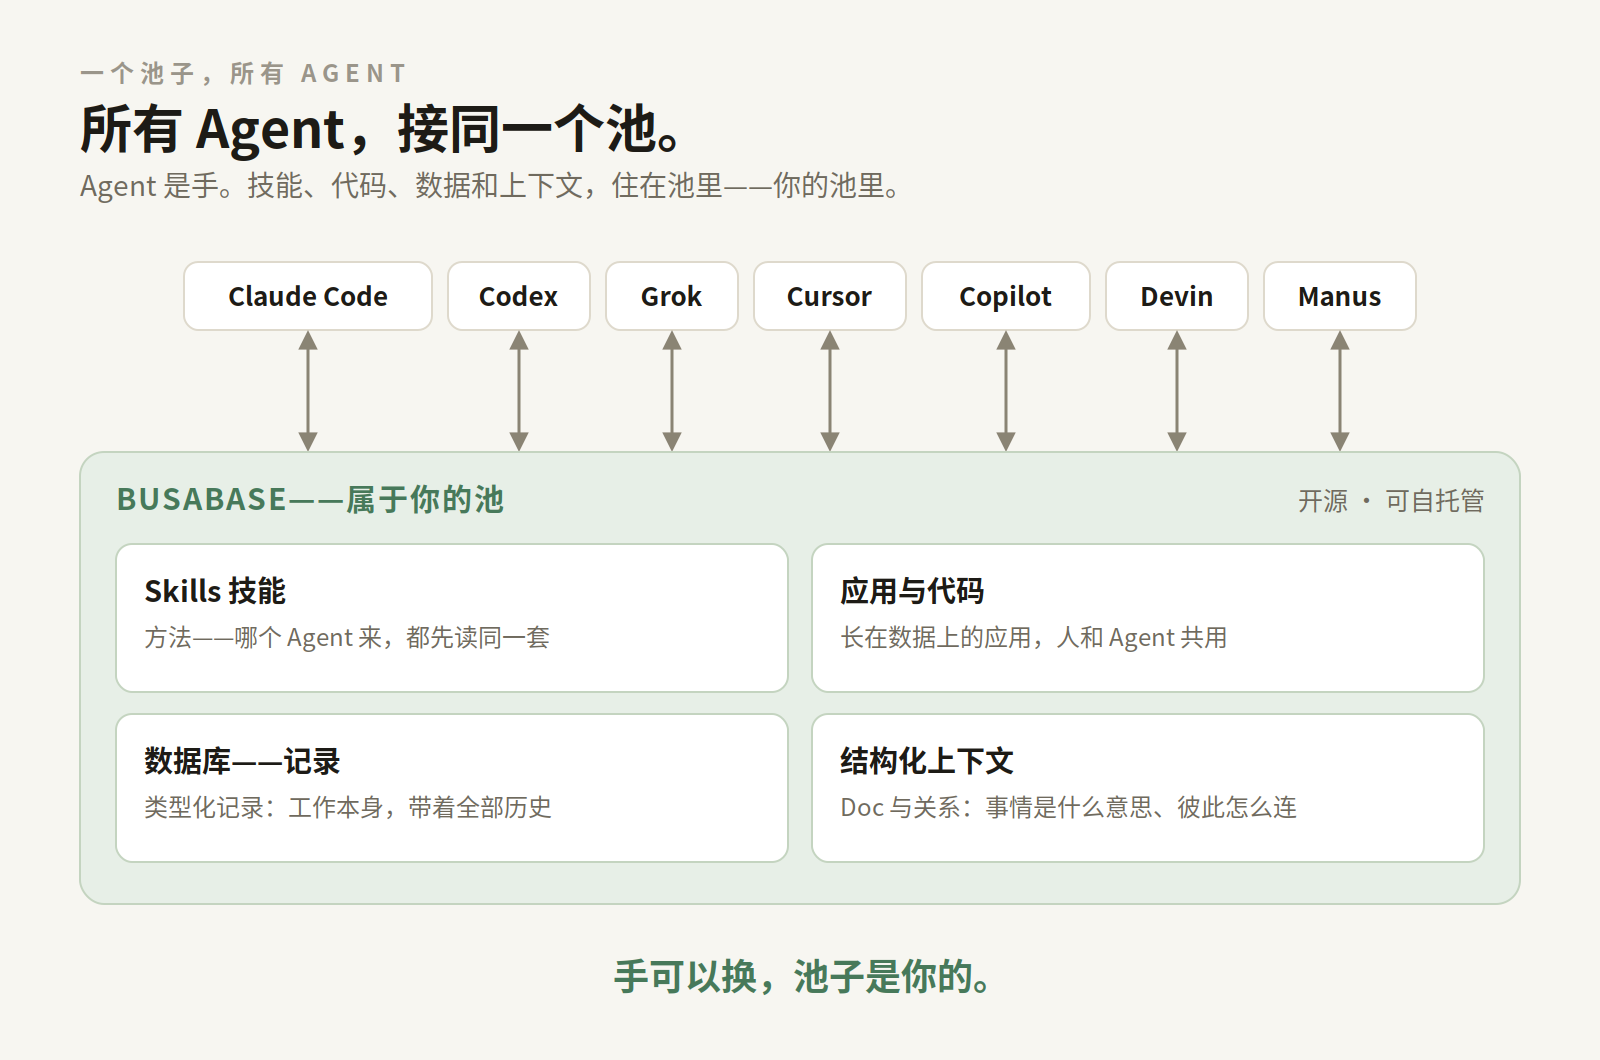
示意图——一个池子,所有 Agent。非产品界面。
这个池,就是一个 Busabase 工作区。它装的东西刻意朴素,四样,全是你的:
- Skills 技能——方法,做成一等节点。池里的一份 Skill 是常驻的作业标准,哪个 Agent 接进来,动手前读的都是同一份;Playbooks 把全部 Skill 和各节点的自定义提示汇成一本目录,「我们这儿这件事怎么做」永远在同一个地方查,不看今天来的是哪只手。
- 应用与代码——长在数据上的 AirApp。你团队早上打开的跟进看板,和 Agent 夜里更新的是同一个对象;应用不长在某个厂商的前端里,它和数据住在一起。
- 数据库——记录——工作本身,做成带类型、带负责人、带状态、带关系的记录。一条线索是一条记录,不是一段实录里的某句话;它的状态,你能查、人能查、下一个 Agent 也能查。
- 结构化上下文——Doc 存常驻口径(什么样的客户算合格、我们永不承诺什么),关系说清事物是什么意思、彼此怎么连——新 Agent 不必从聊天记录里猜你的世界。(至于事物本身——公司、联系人、交易——将会获得一层显式语义定义:Ontology,开发中,尚未上线。)
那 Agent 呢?接入就行——经 Agent Skill、MCP、OpenAPI、CLI 或 ACP 会话;池子里没有内置模型,也不偏爱谁。Agent 甚至可以把自己本地的技能目录直接指向工作区里的某个 Skill 节点,它执行的就该是池里那份原件,而不是它自己留的一份副本。Agent 的每一次写入都走 Change Request——提案、diff、作者、历史都在,池子的积累是在治理下发生的,不是谁嗓门大听谁的。整个架构就这一句:Agent 是手,池子是记忆、是规矩、是账本。手会换,池子在。
换手实演:同一个星期,重过一遍
还是那个星期,换成有池子的版本。(这是走法演示,不是客户案例——请看「什么不需要再发生」。)
周一,Claude Code 做线索跟进:它从池里的 Doc 读 ICP 口径,按跟进 Skill 起草回复、写在一条条线索记录上,每一次发送都有记录可查,写入以 Change Request 留痕。周三,你在试用 Codex:把它连上同一个工作区——接入就是一份技能文件的事——让它接着跟进。它读到的是同一批记录:哪些线索在等、已经发过什么、常驻口径怎么说、上一个 Agent 做过什么、为什么。没人需要再听一遍你周一的那场讲解,因为根本没有那场讲解——上下文从来不在周一的聊天窗口里,它在池里。周五,同事问一条线索为什么没动静。没人去翻实录:记录上有状态,历史里有写入,Change Request 上有谁批过什么。
换掉的是什么?模型、界面、账单。没换的是什么?数据、规矩、上下文、历史、和长在上面的应用。诀窍就这么多——而它成立的前提只有一个:这些东西,从一开始就没存进任何一个 Agent 里。
它变不出来的魔法,也说清
宣言归宣言,边界要诚实。搬进池子,不会把各平台已经替你攒下的记忆导进来——没有任何一家提供这种导出,这正是本文的论据本身;池子从你自己的记录和规矩开始攒,从此积累归你。平台原生的那些顺手之处也带不走:Agent 自己写记忆确实很讨喜,但在池子的模型里,这类学习要落到可审的地方——记成经验记录,评审过后晋升进 Skill——而不是在一个工具内部悄悄复利。仓库里的文件约定也仍然要紧:仓库里的 AGENTS.md 和池里的 Skill 是表亲,不是替代品。至于流程执行,口径和以往一样校准过:运行时的第一版今天在位(手动启动、记录变化触发),字段值触发、定时、Webhook 请求头与审批人选择,是正在落地的那一批。
池子不是一个更大的平台。它是一个决定:让积累——那个真正让 Agent 对你有用的东西——在一个属于你的地方复利,以你能检视的格式、在你定的权限下复利。Busabase 开源,一条命令可自托管;池子可以就住在你自己的机器上——这正是重点。起点我们写在《每个人都将拥有自己的数据库》里,记忆与规则这一层本身,写在《Supabase 与 Busabase 最大的区别》里。
FAQ
那我把 AGENTS.md 全面标准化,不就行了?
该做,这张表有一半就是在建议你做。但 AGENTS.md 只扛得起第一格抽屉:你亲手写的说明。它扛不动平台替你攒的记忆、跑过的历史、和工作本身的结构化状态。文件要标准化,但别把一份文件误当成全部家底。
Busabase 不会成为下一个绑架我的平台吗? 这是最该问的问题,而它的答案可以核查:Busabase 开源,跑在 Postgres(或内嵌 PGlite)之上,一条命令自托管——池子可以放在你的笔记本、你的服务器上,里面的记录、Doc 和 Skill 是你能导出、能检视的。评判它,请用本文评判所有人的同一把尺:积累住在哪里,谁能把它拿走。主权而非租约,是它的设计目标——长版在《主权 AI》里。
我得放弃我最喜欢的 Agent 吗? 不用,这正是重点。Claude Code 干它最擅长的活,下个季度试 Codex,顺手的问题问 Grok。池子不要求忠诚。它只要求一件事:今天哪只手在干活,都干在你的记录上、按你的规矩干,并把状态留在明天那只手找得到的地方。
Agent 会一直换代,池子不必
下个季度会有更好的 Agent。会有调价、会有功能弃用、会有收购——Devin 的用户已经亲历过一次:产品改名、记忆系统在半途被退役。这不是丑闻,这是年轻市场的正常天气。真正的丑闻,是让公司的工作记忆,住在天气吹到哪儿就去哪儿的地方。
所以:停止被 Agent 平台绑架吧。Agent 都留着——谁赢都行。把技能、应用、数据库和上下文,搬进一个署着你名字的池子,让现在和未来的每一个 Agent,都接它干活。
- 先从池子本身开始:《每个人都将拥有自己的数据库》——一条命令自托管
- 池子内部的框架:《Supabase 与 Busabase 最大的区别:记忆和规则这一层》
- 池子里的工作为什么按流程组织:《企业的原子单位是工作流》
- 代码:github.com/busabase/busabase · 文档:busabase.com/docs