Supabase 与 Busabase 最大的区别:记忆和规则这一层
Supabase 是数据库,管你应用的数据;Busabase 是它上面那一层:记录即记忆、Doc 是口径、Skill 是规则、Change Request 是治理。GBrain 靠手搓的那一层,Busabase 内置了。

它以两条短消息的形式出现,在一次普通对话中间:
你 busabase 里面有内置记忆和规则的框架么
所以这个才是你和 supabase 最大的区别?
是。但这句话值得认真答一遍,因为简版很容易说错位置。Supabase 和 Busabase 的区别,不是「一个是数据库、另一个不是」。真正的区别是这一句:
数据库负责存;Busabase 负责记、按规矩办、并且留痕。
Supabase 是数据库:可靠、大规模地装着你应用的数据。Agent 的记忆可以放进去——Garry Tan 的 GBrain,共享模式就跑在 Supabase 上。但记忆长什么结构、Agent 要守什么规则、结果该怎么往回写、每一次改动的历史与审核,这些都不是数据库会自带的东西。在 Supabase 上,那一层要你自己建;在 Busabase 里,它是内置的:Base 是记忆,Doc 是常驻口径,Skill 是规则,每一次写入都以 Change Request 的形式留下作者和历史。这篇文章把两边讲清楚——包括 Supabase 就是更对的选择的那些场合。
Supabase 是数据库——一个很好的数据库
Supabase 自我定位是「Postgres 开发平台」,它就是这个东西。每个项目是一个完整的 Postgres 数据库,外加应用后端需要的那一圈:带行级安全(Row Level Security)的 Authentication、存大文件的 Storage、实时同步的 Realtime、无服务器代码的 Edge Functions、即时可用的 Data APIs,以及在同一个 Postgres 里存、索引、检索向量嵌入的 Vector。它开源,而且这份工作做得非常好。如果你要交付一个应用,这是认真、靠谱的地基。
请注意这份清单的性质:它全是「存放」以及存放周边的服务。数据库忠实地保存行、文件和向量。它不知道什么叫「一条记忆」;它对「哪个事实值得 Agent 留下、人和公司和决定之间是什么关系、你的常驻规则是什么、昨天 Agent 写下的东西谁能改」这些问题,没有立场。
所以有一句话听起来对、其实只对了一半:「Agent 的记忆可以存进 Supabase。」 可以存,就像什么都可以往里存一样。GBrain 就是证据——同时也是另一半的证据。Tan 把 GBrain 的共享部署跑在 Supabase 的 Postgres + pgvector 上,他自己的大脑已经长到 155,795 页、24,589 个人、5,340 家公司。但这个结构没有一寸来自数据库本身。GBrain 就是数据库之上的那一层:一个有自定约定的 Markdown 页面仓库、一个在存下来的片段之上做检索的引擎、一套告诉 Agent 如何摄入、丰富、维护这个大脑的 Skill,还有几十个定时任务整夜做维护。Supabase 存着 GBrain 的数据;GBrain 才是记忆与规则框架——而它是 Tan 自己设计、自己建出来的。
这不是在批评任何一边。这是一份工作说明。问题只是:这份工作,你想不想自己做。
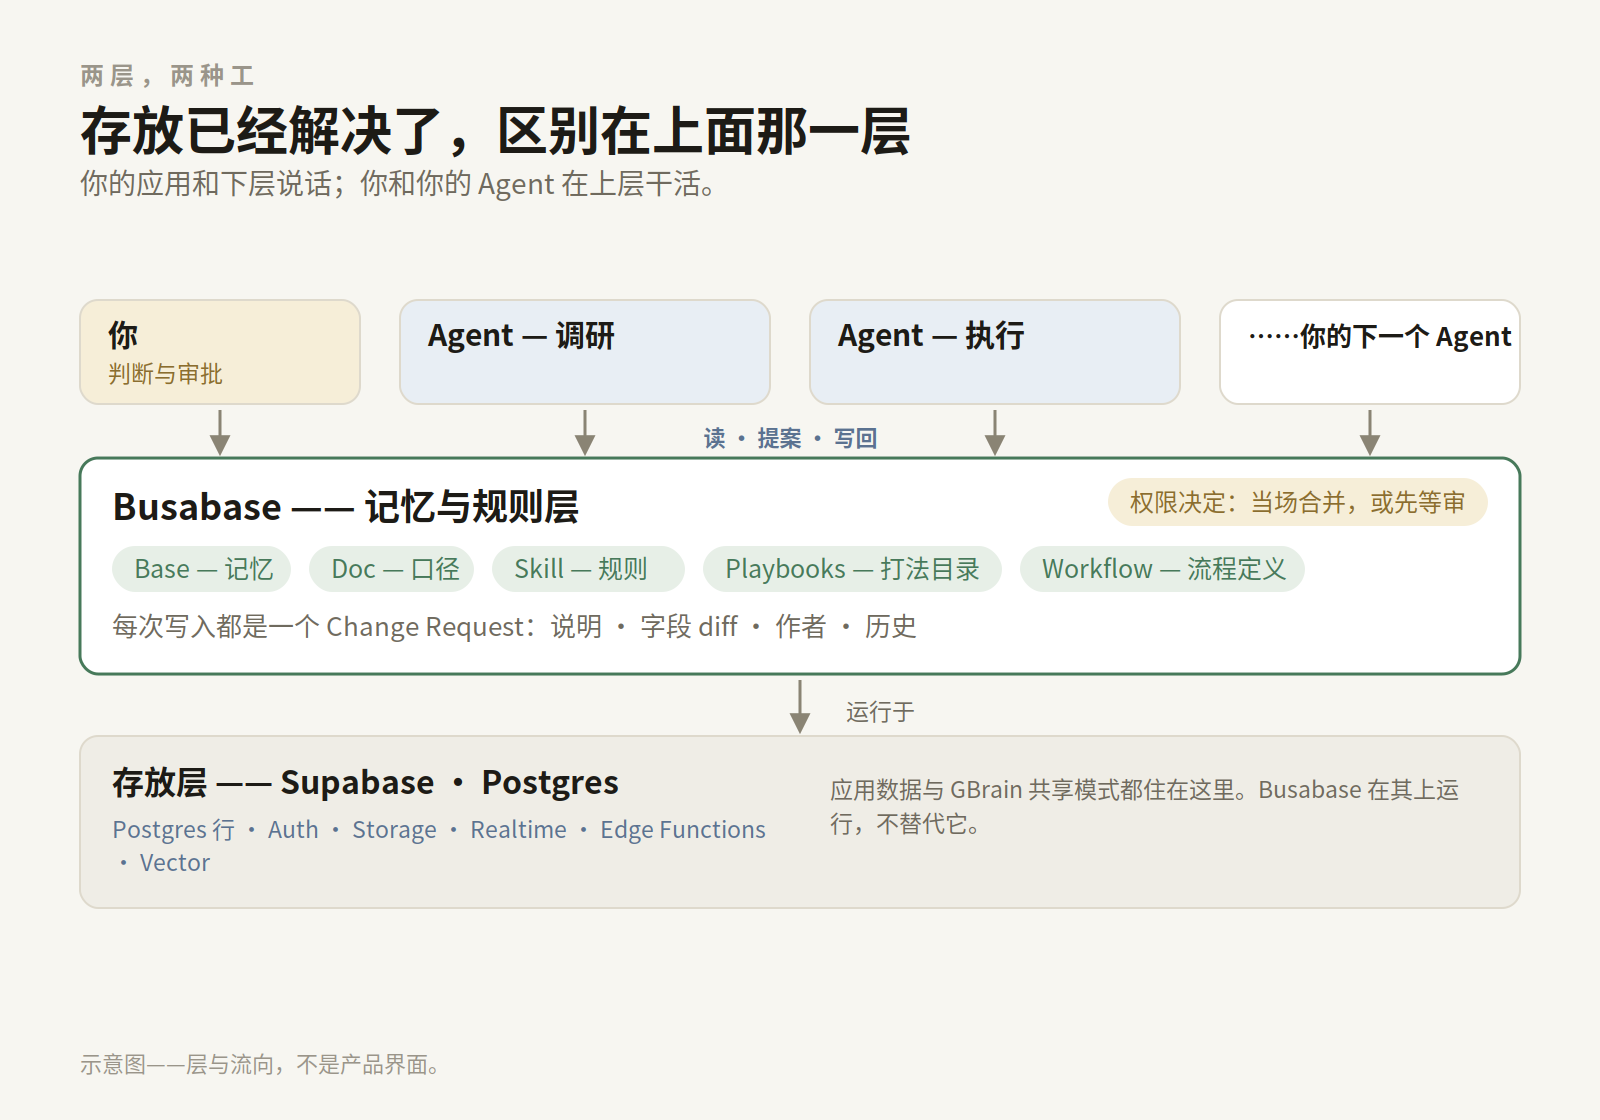
示意图——两层各装什么,不是产品界面。
在裸数据库上,框架是另外五个工程
假设你决定在自己运营的数据库之上,给 Agent 一套真正的记忆。存放是第一天。然后框架的工作才开始——五件事,单看每件都不大,缺任何一件都露馅:
- 记忆的结构。 什么算一条记忆?人、公司、会议、决定怎么表示、怎么互相链接?在数据库里,这是你要设计的表结构;在文件堆里,这是你要维护的约定。无论哪种,都得你设计,而且每个 Agent 必须用同一种写法往里写。
- 检索。 存下来不等于记得住。总得有什么东西决定:这次任务,该把哪些内容放进 Agent 的上下文——检索、排序、图遍历、综合。GBrain 光是检索层就配了一个独立的评测仓库,因为这一件本身就是一个工程。
- 规则放哪、怎么执行。 你的常驻口径(「日期不许承诺」「价格只认现行表」)必须放在 Agent 动手前真的会读的地方,而且它的权威不能靠提示词的礼貌。写在某个 Agent 配置里的规则,会随那个 Agent 一起消失。
- 写回纪律。 记忆要复利,前提是结果回得来:每次任务之后,带上来源,去了重,按第一件定的结构写回。数据库不会让 Agent 自动做到这一点。这是约定——除非你把「默认如此」的机器建出来。
- 审批与权限。 Agent 写得快,也偶尔写错。哪些写入当场生效、哪些等人点头、敏感部分谁能读、写坏了怎么溯源和回退——数据库给你的是角色和行级安全这些原材料,不是一套带 diff、能让人判断的评审流程。
GBrain 被人佩服,正是因为一个人把这五件全建了、建得好,还在 15.5 万页的规模上保持了一致。大多数团队不会这么做——不是不能,而框架是藏在第一个产品里的第二个产品。
Busabase:框架本身就是产品
Busabase 是数据库之上的那一层,为的就是这五件事——让「Agent 记忆」不是一个工程,而是一个打开就能用的工作区。它自己就跑在 Postgres(或嵌入式 PGlite)上;它的 README 明说:它是上面的工作区,不是你应用数据库的替代品。它补的,正是框架:
- Base 是记忆层。 人、决定、项目、经验都是带类型的记录,彼此关联——你一眼能看懂,任何接入的 Agent 都能查;人和 Agent 面对的是同一份、同一种结构的记忆。
- Doc 是常驻口径。 那些长期有效的指引——什么进库、什么永远不进、红线在哪——以文档形式住在同一个工作区里,像其他一切一样有版本,而不是埋在某个 Agent 的系统提示词里。
- Skill 是规则,是一等节点。 Skill 是 Agent 可读的文件树,就住在它管辖的那些 Base 旁边。Agent 动手前先读它;它只能经 Change Request 变更,所以规则的「当前版本」和「变更历史」是同一个东西。Skill 还能复利:Agent 把经验写成记录,人评审、采纳,再晋升进 Skill——上一篇讲自我改进的 Agent 的文章把这个闭环走了一整遍。
- Playbooks 让规则找得到。 所有的 Skill 和每个节点的自定义提示被汇成一个统一目录,Agent 在动手做一件事之前先去查——于是「在这里这件事怎么做」只有一个答案,每个 Agent 用同一种方式查到,而不是五个工具里养出五种习惯。
- Workflow 是框架的执行件。 Workflow 把一份流程以图的形式画下来,住在它所作用的那些记录的同一棵树里——而且它会跑:可以手动启动,也可以由记录的变化触发;这是运行时的第一版,今天已经在位。最近几次发布把它磨得更细:可以只在某个字段变化时才触发,或在字段变成某个指定值时才触发——已经是「就绪」的记录再被编辑,不会误触发;可以定时运行——按间隔、每天或每周,按编辑者自己的时区计算;Webhook 可以带自定义请求头,需要鉴权的接口也够得着;审批步骤里的审批人,从成员名单里选,不用再手打邮箱。和 Skill 是同一条道理:流程在工作区里写定一次,之后每次都按同一份定义执行——不是每轮各发明一遍,也不是只活在某一个 Agent 的脑子里。
- Change Request 是治理层。 Agent 的每一次写入——一条记录、一条规则、一份文档——都以 Change Request 的形式旅行:带说明、字段级 diff、作者和历史。权限决定它当场合并(有写权限的密钥默认如此),还是进收件箱等人。被限制在
changeRequest级别的凭证只能提案,永远落不了地。这正是 Agent 的一次写入算「数」而不只是「存了」的原因:有具名的提案人、看得见的 diff,和一个合并之后仍然留存的决定。
如果今天就动手搭,起步形状可以是这样:
| 节点类型 | 建议名 | 装什么 | 用途 |
|---|---|---|---|
| 文件夹 Folder | Agent 总部 | 下面的一切,收在一处 | 记忆、规则、流程的一个家 |
| Base | 记忆 Memory | 带类型的记录:人、决定、事实——每条带来源与状态 | 所有 Agent 共享的那份记忆 |
| Doc | 常驻口径 | 什么进、什么永远不进、审批红线 | Agent 当作既定前提读的政策 |
| Skill | 作业规则 | 方法、写回纪律、去重键、汇报格式 | 会复利的那套规则 |
| Workflow | 每周评审 | 评审流程画成图,就放在它评审的记录旁边 | 换了人也不会丢的流程 |
起步设计——名字和字段按你自己的工作调整。
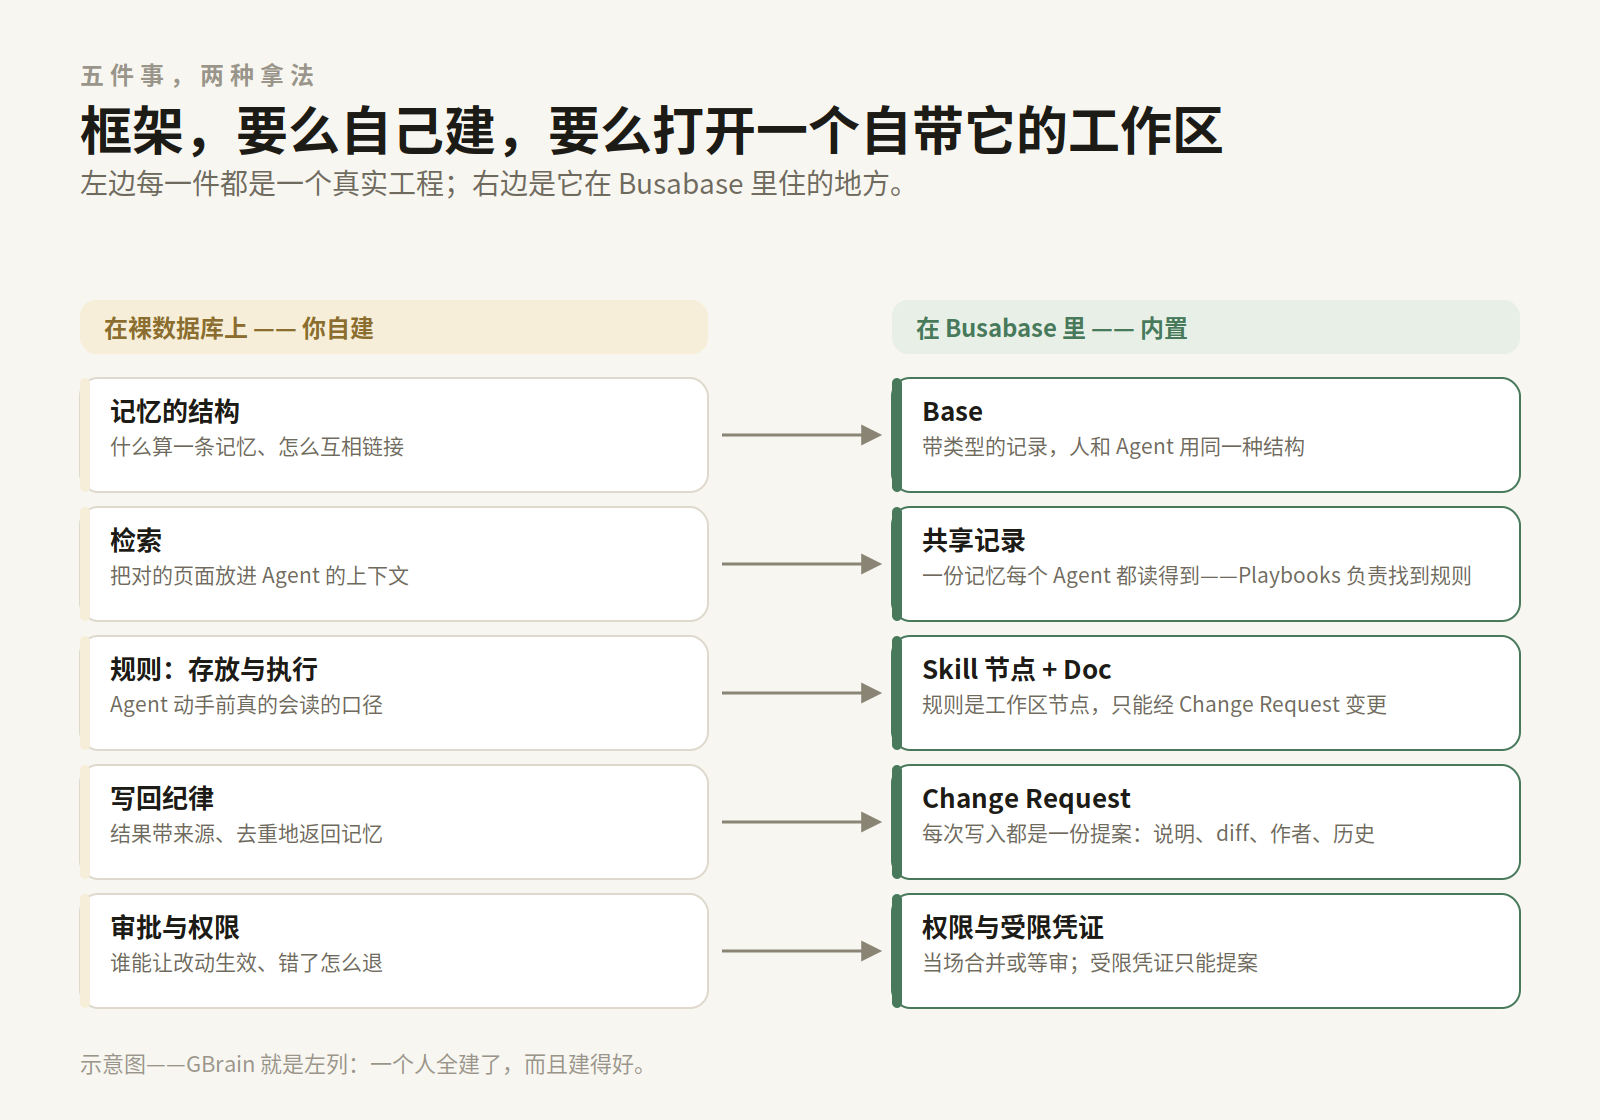
示意图——GBrain 就是把左列五件手工全建了一遍的那个例子。
正面对照
| 维度 | Supabase | Busabase |
|---|---|---|
| 存什么 | 你应用的数据:Postgres 的行、文件、向量 | Agent 的工作记忆:带类型的记录、文档、Skill、流程定义 |
| 谁来读 | 你的应用代码;开发者 | 人和 Agent,在同一个工作区、同一份记录上 |
| 规则写在哪 | 在你的代码与提示词里——或装进 Agent 环境的技能包里,始终在平台之外 | Skill 节点和 Doc 里,在工作区内,有版本、可评审 |
| 变更怎么记录、怎么审 | 历史与评审流程要你自建(角色与行级安全是原材料) | Change Request:字段 diff、作者、历史、回滚;要不要审你来定 |
| 换 Agent 时发生什么 | 旧 Agent 攒在自己上下文和文件里的东西会被搁浅——除非你建了共享层 | 什么都不用搬:记忆、规则和 Playbooks 住在库里,不住在 Agent 里 |
| 你要自建什么 | 整套记忆与规则框架(GBrain 是参照实现) | 内容本身:你工作里的记录、口径和 Skill |
两列都不是对另一列的判决。它们是两个不同的层,只是都涉及「存东西」——这正是这个对比总让人糊涂的原因。
两层怎么叠:什么时候用哪个
该用 Supabase 的时候:你在给一个应用做后端——用户账号、实时功能、文件存储、应用规模的 SQL 与向量查询。这是它的主场,而且它在这个主场非常出色。Busabase 不抢这个工种——它本来就不是应用后端。
该用 Busabase 的时候:要存的是 Agent 的记忆和它们干活的规则——它们必须记得的人和决定、必须遵守的口径、以及人必须能评审的那些写入。这个框架,就是产品本身。
两者都要的时候——对 Agent 用得深的团队来说,这其实是大多数时候。应用数据住 Supabase;Agent 的共享记忆、常驻口径和 Skill 住 Busabase,任何你接入的 Agent——Claude Code、Codex、Cursor,或者你自己的——都在同一套治理下读写。两层能叠,正因为它们从来不是竞争关系:Busabase 自己,就跑在 Postgres 上。
下一步:给记录层加一层 Ontology(开发中)
框架的下一层正在开发:给记录层加一层 Ontology(本体)。它现在还不能用,所以先说清它是干什么的。你在已有的 Base 之上,定义团队天天在说的业务对象——Company、Contact、Deal——以及它们之间的关系,底层数据不复制到任何地方。这样人和 Agent 共用一套词汇,每个对象都能追溯回它的来源记录。本体也服从本篇所讲的同一套治理:对它的修改同样走 Change Request。结构化的记忆是「找得到」;实体与关系被显式定义过的记忆,是每个你未来会接入的 Agent 都能以同一种方式「读懂」的。状态说准:开发中,尚未上线。本篇的任何主张都不依赖它。
常见问题
能拿 Supabase 当 Agent 的记忆吗? 能存——GBrain 就这么干。但数据库给不了框架:记忆的结构、规则层、写回纪律、对 Agent 写入的评审,都要你自己设计和维护。如果「建这一层」正是你想做的事,那它是个成立的工程;如果不是,那正是 Busabase 替你省掉的部分。
什么让 Agent 对数据库的一次写入算数? 不是写入动作本身,而是它周围发生的事。在 Busabase 里,Agent 的一次写入是一个 Change Request:它署名、展示字段级 diff,按你设的权限当场合并、或等一个人做决定,而且整条轨迹在合并之后依然留存。一行凭空出现在表里的数据,只有「存」;一次带出处的变更,才有「数」。
必须二选一吗? 不必。它们回答的是两个问题。Supabase 回答「我应用的数据住哪」;Busabase 回答「我的 Agent 在哪记忆、按什么规则干活」。很多团队会两个一起跑,一层叠在另一层之上。
从你缺的那一层开始
如果你的 Agent 已经有地方存东西,却还是健忘、重复决策、写了不留痕,你缺的不是更多存储,而是它上面那层框架。本系列的上一篇《每个人都将拥有自己的数据库》 用一条命令装好 Busabase 开源版,并附了那段把整套搭建交给 Agent 的提示词。想看这套对比背后的分类学,去读 《Agent 记忆、知识库与记录系统》;常青的选型页在 Busabase vs Supabase;想看它和 Notion 怎么搭配,见 Busabase:Notion 和 Supabase 的混合体。