
知識ベースにファイルがあっても、現在の検索可能テキストがあるとは限りません。PDFが未抽出だったり、更新前の抽出が残っていたりします。
ゼロ件には、資料なし、対象範囲不足、古いテキスト、本当に一致なしという異なる意味があります。別の語を試す前に、その結果で結論を出せるかを判断します。
ゼロ件の前にcoverageを見る
coverageとtruncatedを確認します。missing、stale、errored、notReached、truncated trueがあれば、完全な対象範囲での否定には使えません。ファイルの未抽出と別ソースの未到達は別の問題です。
maxMatchesを増やすだけでなく、ソースを選び、Base slugやDriveパスで範囲を絞ります。未供給は供給、古い内容は再抽出で対処します。キーワードの変更はそれらの代わりにはなりません。
結果の出典、行、列、周辺文から位置を特定し、必要な行範囲を読み戻して引用を確かめます。ファイル結果には所有するSkillやDriveもあり、同名ファイルの区別に使えます。
保存と検索可能な表現を分ける
検索ガイドでは、Markdown、JSON、CSVなどはUTF-8の内容自体を使います。PDF、Office文書、画像、録音などのバイナリは、外部ツールかAgentで抽出・OCR・文字起こしを行いAssetへテキストを供給します。Busabaseは供給された内容を保存・検索し、OCRや解析器を内蔵して実行するものではありません。
ダウンロードできることだけでは、grepが現在の全文を読めると判断できません。まずどの表現が検索対象かを確かめます。
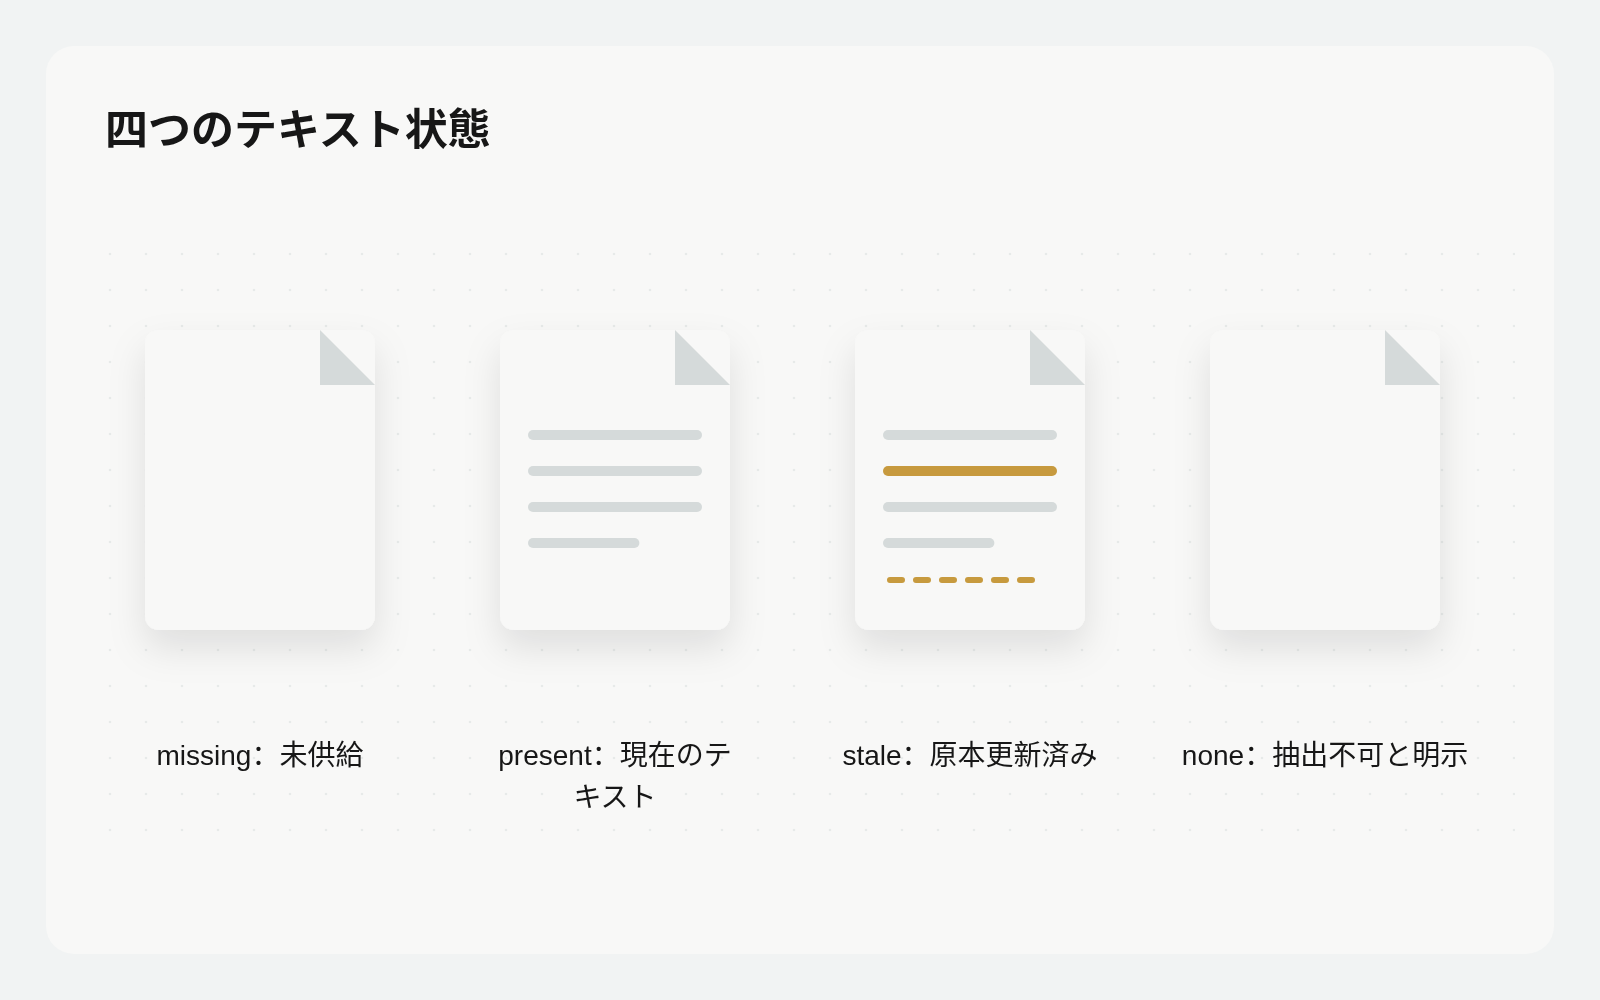
textStatusは四種類です。missingは未供給、presentは現在の検索テキストあり、staleは供給後に原本が更新、noneは抽出可能なテキストなしと明示した状態です。noneは業務上の情報が存在しないという意味ではなく、後で抽出可能になれば供給できます。
探したいものに合わせて検索する
保存済みの方法を探すならplaybooks search、正確な文字の位置ならgrep、関連度順の結果ならsearchを使います。searchには未承認ChangeRequestの草稿も含まれますが、長い項目の照合は先頭8,000文字までです。全文の言い回しの確認にはgrepを使います。
grepはファイルテキスト、Doc本文、マージ済みレコードの現在値、ノードのカスタムプロンプトを対象とします。草稿とマージ済みの違いをデータ消失と決めつけません。
原本と抽出テキストを揃える
Asset詳細で検索テキストの供給、置換、プレビューができます。APIのputTextはUTF-8を供給し、1MB以下は直接、それ以上はアップロード後に結びつけます。再供給すると以前の検索表現を置き換えます。原本が更新されたら、その新しい内容から抽出し直します。
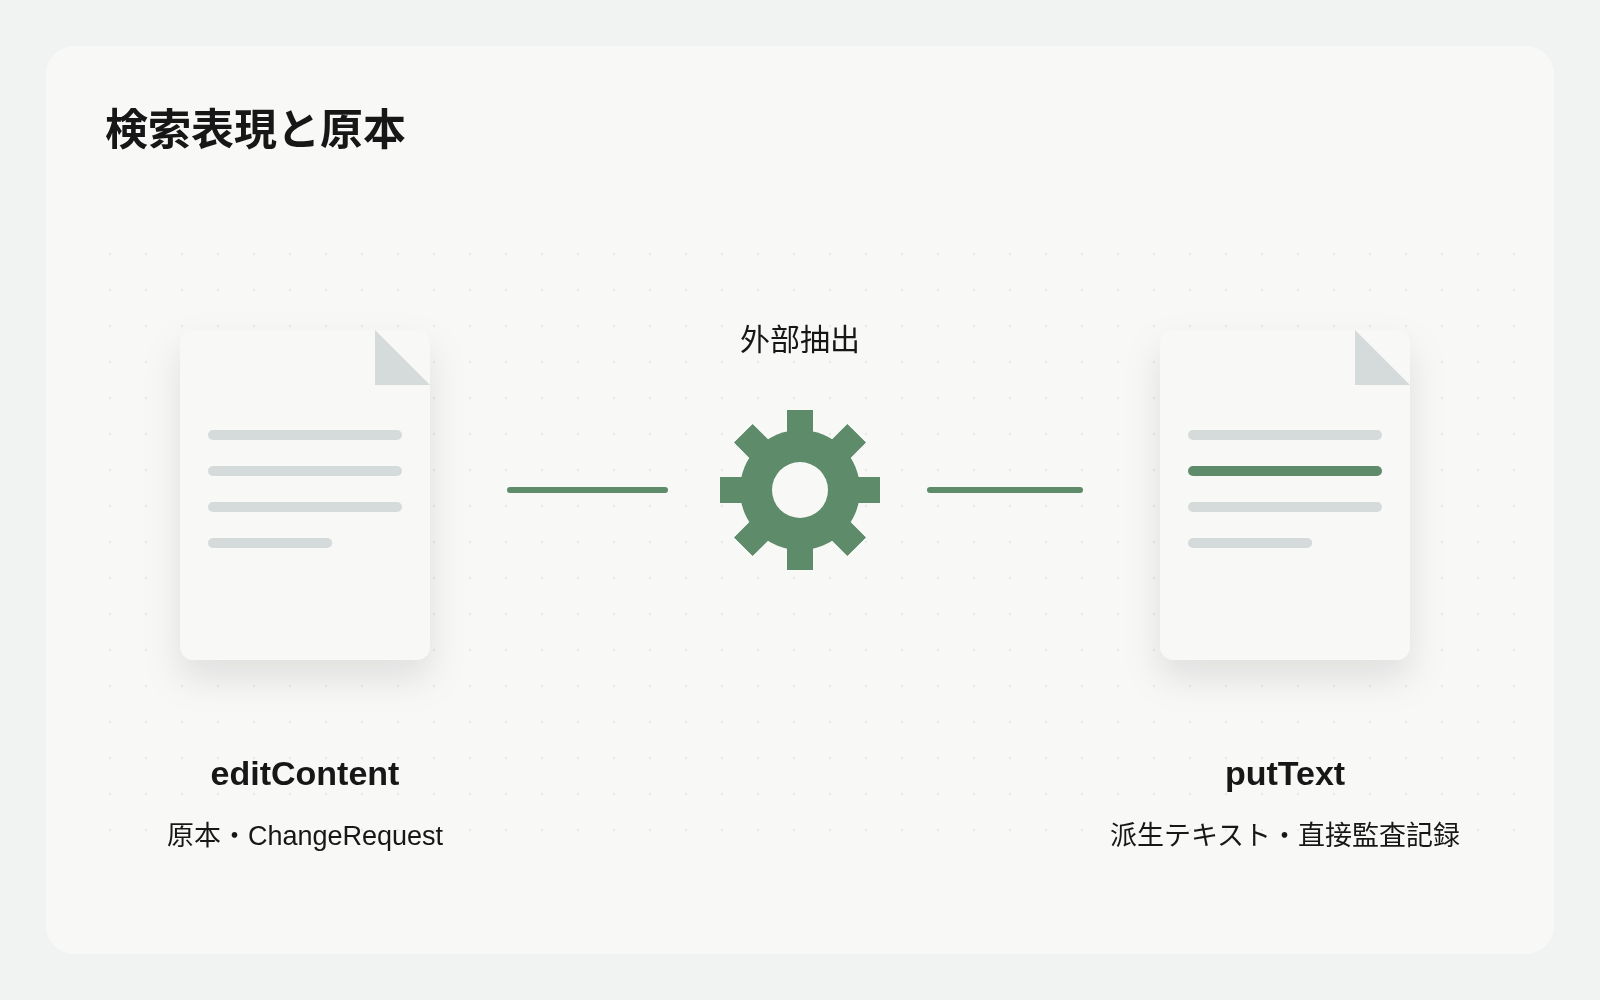
putTextは検索・行読みに使う派生表現を直接変更し、監査記録を残します。PDFや原本は変えません。editContentはマウントされたDriveやSkillのテキスト原本をChangeRequestで変更し、書き込み権限があれば即時マージ、それ以外は審査を待ちます。原本の修正にputTextを使いません。
外部抽出サービスを使う前にデータ利用とツールの許可を確認します。原本の版と抽出結果を対応づけ、何を読んだテキストか追えるようにします。
一回の点検を再利用できる形にする
既存の資料管理Baseに、元Asset、担当者、状態、原本更新の根拠、抽出方法、確認時刻、検索範囲の不足、次の対応を残す設計が考えられます。これは管理案であり、表を作るだけで抽出や検索精度改善が動くわけではありません。
対象資料のtextStatusを調べ、missing、stale、noneを整理してください。精密検索ではcoverage、truncated、該当位置を示し、必要な行を読み戻します。未検出と網羅不足を分け、読み取りだけを行います。再アップロード、外部抽出、検索テキストの変更は行いません。
確認後に権限のあるAgentが不足分を供給し、同じ質問と範囲で再確認します。状態、範囲、現在の原文を基準に受け入れ、測定していない再現率は書きません。
ゼロ件のあとに補う不足を選ぶ
missingは検索テキスト、staleは原文と抽出の版、truncatedは対象不足を扱います。再検索だけでは解決しません。noneの根拠も現在ファイルで確かめ、OCRを無限に繰り返しません。
命中行も条件や表の関係を省く場合があります。前後を読み戻して結論と出典を示します。原文修正が必要なら源操作を使い、putTextで望む答えを作りません。
原本更新と一緒に検索の根拠も更新する
原本更新を誰が知らせ、誰が再供給し、誰が状態を確認するかを決めます。まず実際に見つからなかった一件を最後まで確認してから資料全体に広げます。
検索失敗に対する有用な回答は、どの表現が不足し、最後にどの原文が答えを支えるかです。再試行の指示だけで終わらせない点検に変えられます。