
10月30日、YC のポッドキャスト Lightcone に Supabase の共同創業者兼 CEO、Paul Copplestone が出演した。タイトル自体が一つの予言になっている——「Why Everyone Is About To Have Their Own Database(誰もが自分のデータベースを持つようになる)」。数字がそれを裏付ける。Supabase の登録ユーザーは1300万人、1年前は約300万人だった。毎週100万を超える新しいデータベースが生まれ、管理下のデータベース総数は1年前の800万から5000万に迫っている。そして司会陣によれば、新しいアクティビティの約70%は人ではなくエージェントから来ている。
Copplestone の説明は明快だ。「自分のデータベースを所有し、その上にアプリケーションやエージェントを構築したいはずだ」——データベースは記録の保管場所(store of record)であり、アプリやエージェントが入れ替わっても、残り続けるものだという。
同じ回には「個人版」の実例も登場する。YC パートナーの Harj Taggar は、自分用に構築中の個人システムについて語った。メールの仕分け、財務、健康管理が一か所に集まっている。さらに彼は、自分の CRM を特定のエージェントの中から意図的に切り離し、「上にどのエージェントを接続しても使える」ようにしているという。彼の結論はこうだ。「1年前なら、個人データベースが欲しいなんて思わなかった。でも今では、それが実は一番価値のあるものだ」。そして Garry Tan の GBrain——Supabase の上に構築された個人エージェントの「脳」——も同じ理由で存在する。現在のコンテキストウィンドウしか見えないエージェントは、すでに答えた質問を何度も聞き返してくるからだ。
この番組の主張に、私たちは同意する。本稿で扱うのは、その主張が見落とした「層」の話である。
データベースは保管場所。個人データベースは「仕事場」でなければならない
Postgres は、アプリケーションが読み書きするためのものだ。ソフトウェアの下に必要なのは、まさにそれでいい。しかしあなた自身が Postgres の中で仕事をすることはないし、あなたのエージェントも生のテーブル群に放り込むべきではない。
人とエージェントが毎日実際に触れるのは、別の層——人、会議、意思決定、プロジェクト、学んだこと。これらは「記録」であって、スキーマを覚えなければ読めない行ではない。求められるのは三つ。一目であなたに分かること。接続したどのエージェントでも読み書きできること。そして書き手が人・エージェントを問わず複数になったとき、すべての変更に作者と履歴が付き、確認できること。
Busabase は、その層のためのものだ。Postgres の代替ではない——Busabase 自身が Postgres、あるいは組み込みデータベース PGlite の上で動き、公式 README にも明記されている。「アプリのデータベースの代替ではなく、その上のワークスペース」だ。アプリのデータはあるべき場所に置けばいい。一方、エージェントが暮らす記録層のために、Postgres とベクトルストアとグラフ層を自分で組み立てる必要はない。Busabase のオープンソース版をインストールすれば、その層がコマンド一発で手に入る。
インストール:コマンド一つ、先に用意するデータベースはなし
自分のマシンで:
npx -y busabase@latest server
そして http://localhost:15419/dashboard/local を開く。用意すべきデータベースも、アカウントも、設定ファイルもない。サーバーは組み込みの PGlite、ローカルファイルストレージ、そして触ってから消せるデモワークスペースと一緒に起動する。データはあなたのマシンの ~/.busabase/data/ に保存される。
形の選択肢もある。いずれも同じエンジン、MIT ライセンスだ。Docker(docker run --rm -p 15419:15419 -v ~/.busabase/data:/data busabase/busabase)、グローバルインストール(npm i -g busabase の後に busabase server)、あるいは busabase.com/download のデスクトップ版(macOS / Windows / Linux)。Busabase Cloud を動かしているのと同じエンジンである。
先に進む前に、プロジェクト自身が明記している境界を一つ共有しておく。オープンソース版サーバーは、信頼できるローカルマシン、あるいはプライベートネットワークを前提に設計されている。認証とリバースプロキシなしに、書き込みエンドポイントを公共のインターネットへ公開してはいけない。個人データベースの価値は「あなたのものである」ことから生まれる。その前提を守ってほしい。
セットアップはエージェントに渡す:コピペ用プロンプト
GBrain の INSTALL_FOR_AGENTS.md が正しく捉えたことが一つある。本稿もそれにならう。2026年、インストール手順を読むのは、ますますエージェントの側なのだ。だから手作業の手順を並べる代わりに、プロンプトを一つ用意した。個人データベースを置きたいマシン上で、いつも使っているエージェント——Claude Code、Codex、Cursor、あるいはコマンド実行と URL の読み取りができる任意のエージェント——に、そのまま貼ってほしい。
あなたは私のセットアップ担当エージェントです。このマシンに Busabase を
インストールし、私の個人データベースを構築してください。下記の公式の
方法だけを使い、コマンドやスキーマを即興で作らないこと。
ステップが失敗したら、回避せずに止まって報告してください。

1. サーバーが起動していなければ起動する:
   npx -y busabase@latest server
   ダッシュボードは http://localhost:15419/dashboard/local です。
   アカウントも、別途用意するデータベースも不要です。組み込みデータ
   ベースとローカルファイルストレージで起動します。

2. Busabase Agent Skill を読み、その指示に従ってください。このワーク
   スペースへの接続に関する唯一の情報源です:
   http://localhost:15419/SETUP_SKILL.md
   ワークスペースへの変更はすべて、busabase-cli でローカルサーバー
   (http://localhost:15419)に対して実行してください。

3. このワークスペースに「Personal Base」というフォルダを作り、その中に
   次を作成してください:
   - Base「People」:名前 · 役職 · 組織 · 連絡先リンク · 背景 ·
     最終連絡日
   - Base「Meetings & Decisions」:タイトル · 日付 · 参加者(People に
     リンク) · 決めたこと · なぜ · フォローアップ
   - Base「Projects」:名前 · ステータス · 担当者 · 重要な決定
     (Meetings & Decisions にリンク) · 次のアクション · リンク
   - Base「Experience」:学び(一文) · 出典レコード · 当てはまる場面 ·
     当てはまらない場面 · ステータス(候補 / 採用済み / 引退)
   - Doc「How I work」:このベースに入れるもの、絶対に入れないもの、
     そして常にかならず私の承認を待つもの——お金、約束、日付
   - Skill「Personal Base operator」:すべてのタスクの前に People、
     Meetings & Decisions、採用済みの Experience を確認すること。
     すべてのタスクの後に、結果を出典とともに書き戻すこと。同じ連絡先
     リンクの People レコードを二つ作らないこと——既存のものを更新する

4. 検証:作成したノードを一覧で私に見せ、各 Base からレコードを1件
   ずつ読み取り、構造が実在することを示してください。ダッシュボードの
   URL、作成したもの、私が最初に確認すべき点を報告してください。

5. マージ方針を自分で選ばないでください。変更は都度提出し、今すぐ
   マージされるか私のレビューを待つかは、私の権限に委ねてください。
   パスワード、トークン、その他いかなる秘密も、どのレコードにも
   保存しないでください。
このプロンプトの中身は、すべて公式の仕組みだけだ。起動コマンドとセットアップ用 Skill はプロジェクトの README 由来で、構造は次節の設計図そのもの。得られるのは分業だ。繰り返しの構築作業はエージェントが行い、あなたは最後に一度、検証だけを行う。
設計図:個人ベースの中身
意図的に小さくしたスターター設計である。1フォルダの中に、Base が4つ、Doc が1つ、Skill が1つ。
| ノード種別 | 推奨名 | 主要なフィールド/内容 | 役割 |
|---|---|---|---|
| フォルダ | Personal Base | — | 以下すべてを一か所にまとめる |
| Base | 人物 People | 名前 · 役職 · 組織 · 連絡先リンク(重複排除のキー) · 背景 · 最終連絡日 | 1人1レコード。エージェントは名前ではなく連絡先リンクで人を特定する |
| Base | 会議と決定 Meetings & Decisions | タイトル · 日付 · 参加者(→People) · 決めたこと · なぜ · フォローアップ | 決定とその理由を、それが起きたチャットの外に残す |
| Base | プロジェクト Projects | 名前 · ステータス · 担当者 · 重要な決定(→Meetings & Decisions) · 次のアクション · リンク | 新しいエージェントは、説明を受け直す代わりにこれを読む |
| Base | 経験 Experience | 学び(一文) · 出典レコード · 当てはまる場面 · 当てはまらない場面 · ステータス(候補/採用済み/引退) | 修正を、一回きりの手戻りではなく再利用できる判断に変える |
| Doc | 運用方針 How I work | 入れるもの、絶対に入れないもの、お金・約束・日付に関する承認ルール | あなたが定めた基準。エージェントは動く前に読む |
| Skill | 個人ベース運用 Personal Base operator | 日々のループ、書き戻しルール、重複排除キー、失敗時の停止リスト、報告形式 | 接続したすべてのエージェントが従う、再利用可能な手順 |
効いてくる設計判断は二つ。第一に、決定を独立したレコードにし、「なぜ」の欄を持たせること。半年後に価値があるのは決定そのものより理由のほうで、理由こそチャットが真っ先に失うものだからだ。第二に、経験には「採用」の関門があること。エージェントが提案する学びはまず「候補」であり、あなたが確認したものだけが「採用済み」になり、タスク開始時に読み込まれるのは採用済みだけ。この関門が、個人データベースが自信過剰な思いつきで埋まるのを防ぐ。
ループが閉じる様子を、架空の例で示す(例示)。月曜9時、エージェントが先週の会議を読み、今日の優先順位の草案をチャットに持ってくる。あなたは返す。「ベンダーとの電話を木曜へ。月曜の午前には外部の電話を入れないで」。エージェントは日程を変更し、変更を会議レコードへ書き戻し、経験テーブルに候補を1件登録する——「月曜午前に外部の電話を入れない」。あなたが「採用済み」に変える。翌週の月曜、草案は最初からそのルールを守っている。そして3か月後にエージェントを乗り換えても、新しいエージェントは同じように守る。学びは古いエージェントの中ではなく、ベースの中にあるからだ。
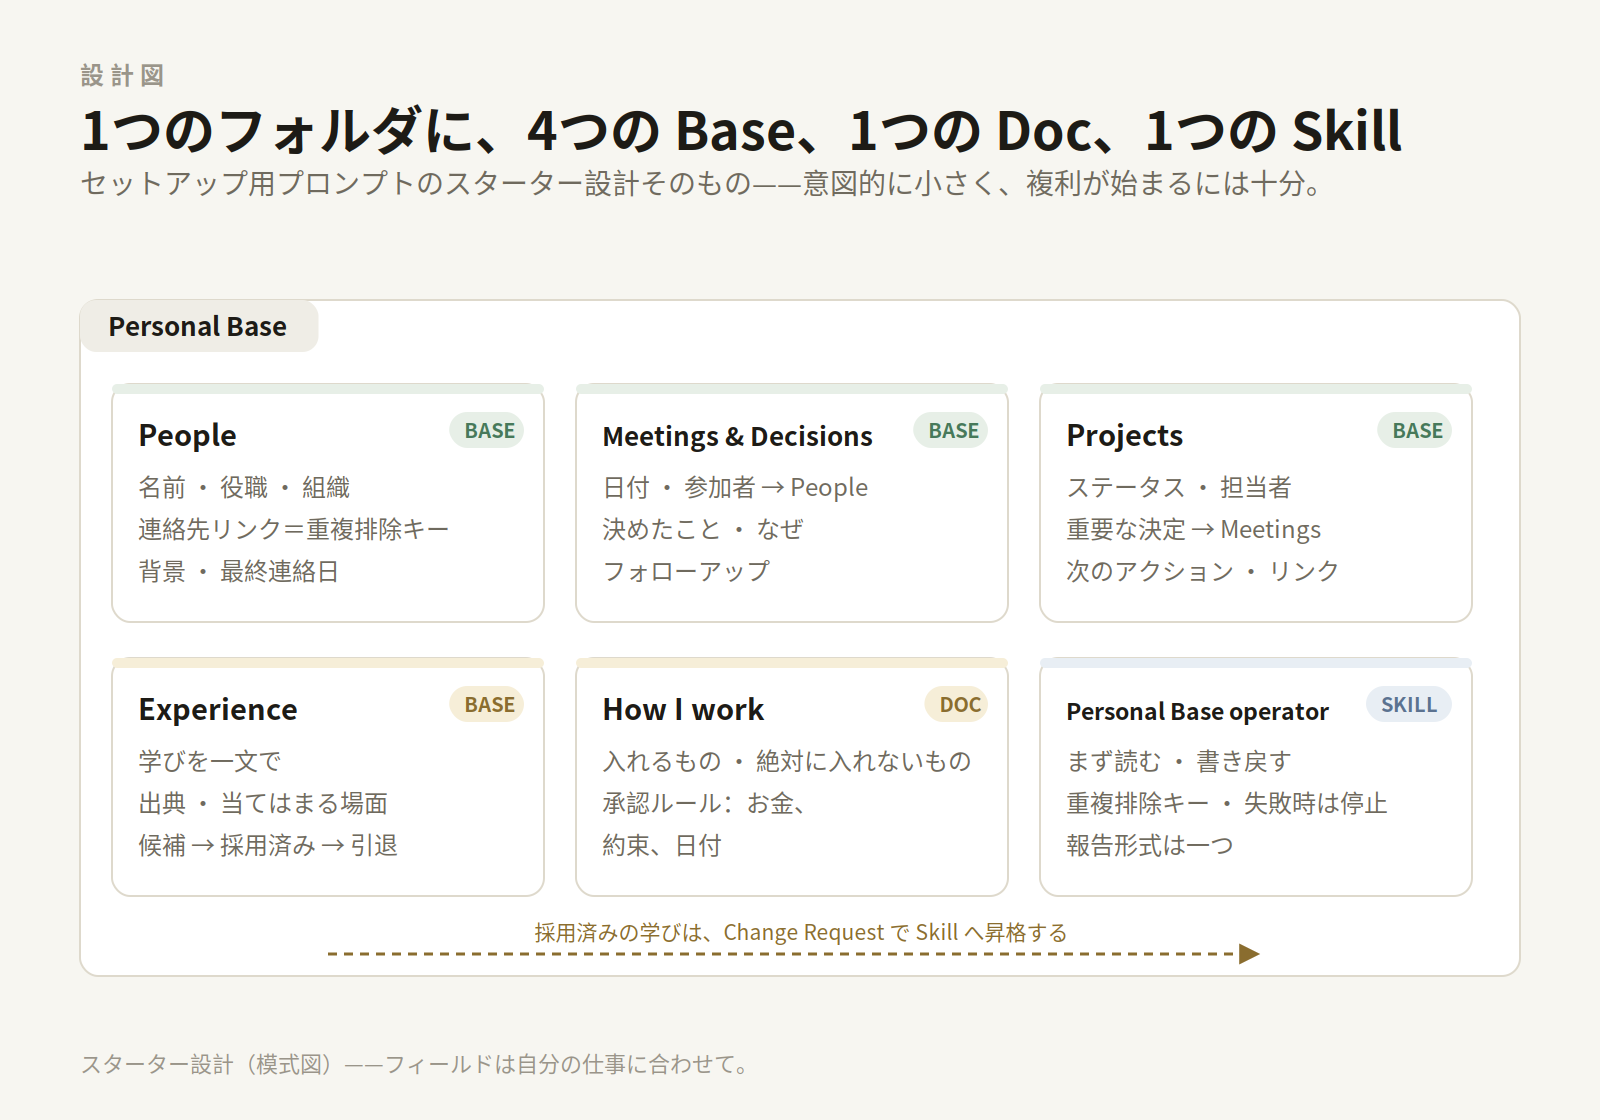 スターター設計図(模式図)。フィールドは自分の仕事に合わせて調整を。
日々のループ:まず読み、書き戻し、記録を残す
個人データベースが複利で効くかどうかは、ループが毎日回るかにかかる。動きは三つに絞る——観察する、決める、実行する。
- 仕事の前に、エージェントが読む。 今日のフォローアップ、関係する人物と決定、採用済みの経験。「すでに答えた質問を二度聞くな」はこのステップで実現する。答えはたいてい、すでにベースの中にある。
- 提案はチャットへ、決めるのはあなた。 ブリーフ、返信文、計画——エージェントが草案を持ち込み、あなたが同意、修正、却下する。お金・約束・日付に関わるものは、Doc の定め通り、必ずここで止まる。
- 仕事の後に、エージェントが書き戻す。 結果は、出典とともに、本来のレコードへ収まる。明日の実行——そして来年のエージェント——が読むのは「計画」ではなく「実際に起きたこと」だ。
Busabase への書き込みは Change Request として運ばれる。すべての変更に、メッセージ、フィールド単位の diff、作者、履歴が付く。ローカルで一人+一エージェントなら大半の変更はその場でマージされるが、diff と履歴はどちらの場合も残る。「何が変わり、誰が変えたか」には常に応えられる。書き込みが失敗したら、セットアップ用プロンプトの規則通り——止めて報告し、決して即興で回避しない。
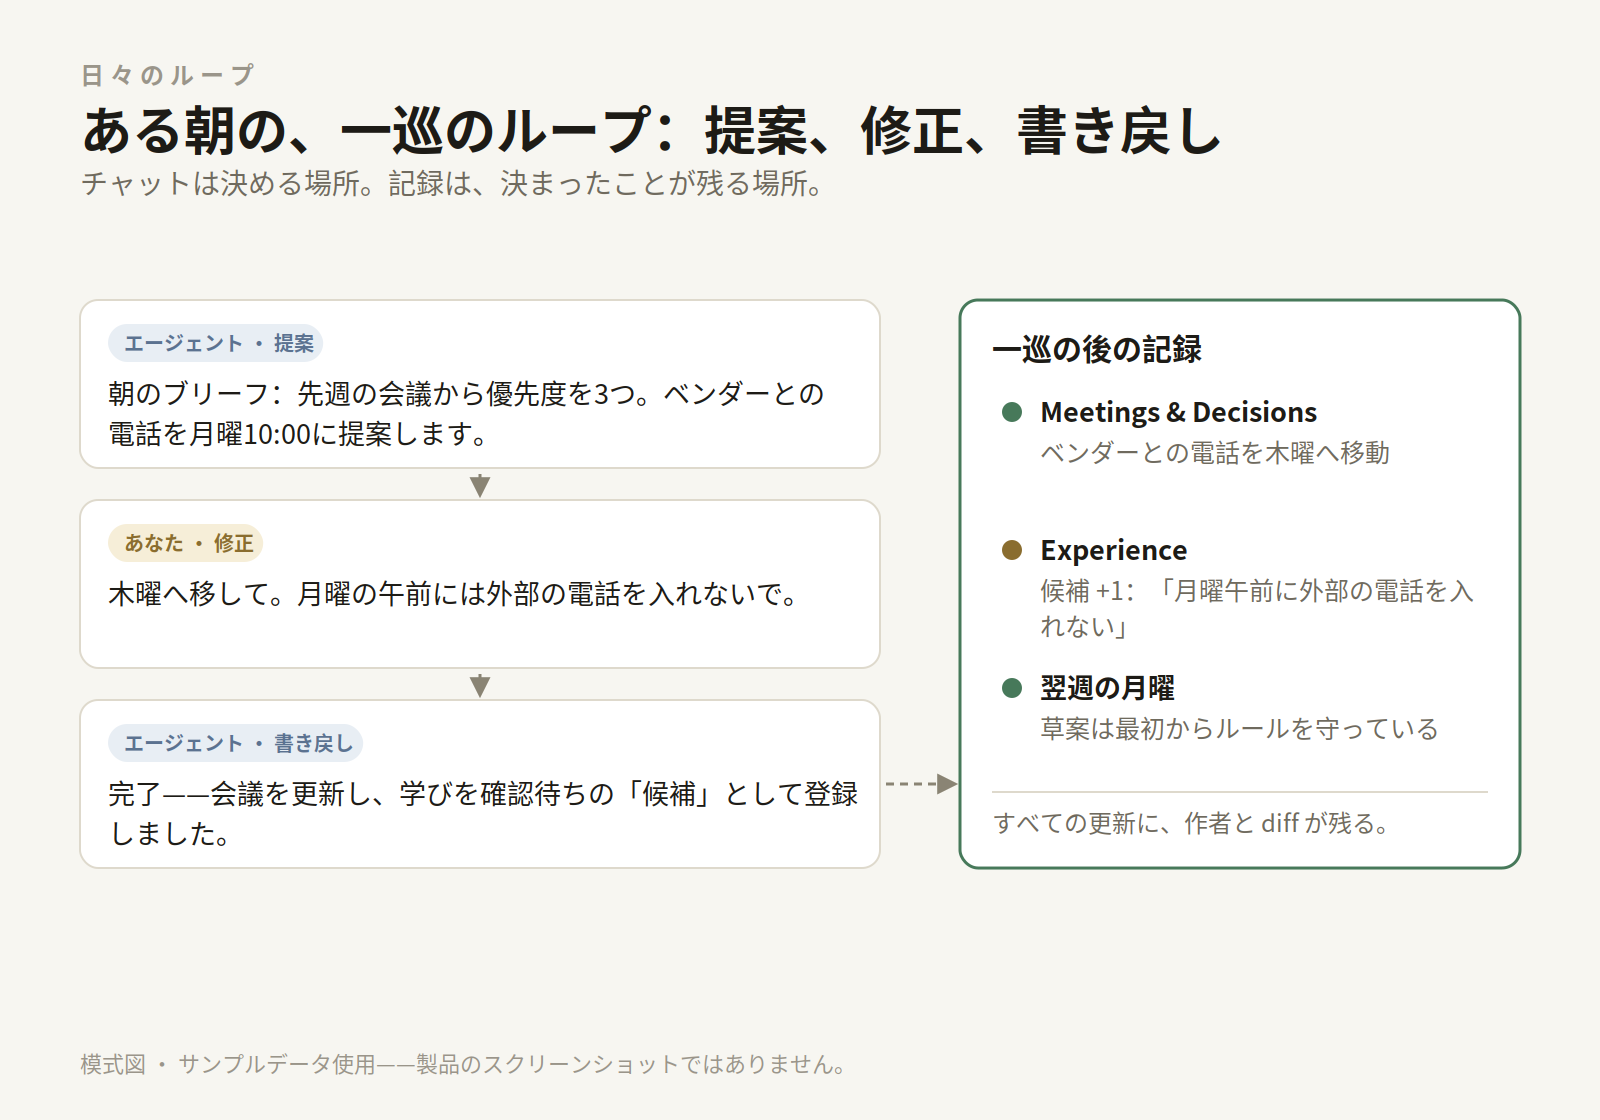 一巡の流れ(模式図、サンプルデータ使用。製品のスクリーンショットではありません)。
大きくなったら:チーム、企業、そして複数のエージェント
個人データベースは、このパターンの終点ではなく出発点だ。二人目の人間——あるいは役割の異なる二人目のエージェント——が加わった瞬間、四つの痛みが決まった順序で現れる。
- 書き手が二人、真実が二つ。 あるエージェントのメモはそのチャットの中に、別のエージェントのメモはどこかのドキュメントの中に。どの決定が最新か、誰にも言えない。
- 作者のいない変更。 あるレコードが夜のうちに変わっていた。調査エージェントか、日程エージェントか、それとも人か。出所がなければ、驚きはすべて調査案件になる。
- 新しいエージェントへの説明のやり直し。 知識が前のエージェントの中に住んでいるため、ツールを替えるたびにプロジェクトを説明し直すことになる。
- 全員に全部が見える。 財務の行とインターンの実験場が同じ場所にある。個人用セットアップには境界が必要なかったからだ。
これらはまさに、同じシステムの「共有形態」が解く痛みである。Busabase Cloud は、同一エンジンをホスト型のマルチユーザーワークスペースとして動かす。スペースにロールと権限があり、人・エージェントを問わず、誰が何を見て何を変えられるかを決める。Change Request は協働のプロトコルになる。すべての変更が diff、作者、履歴を持つ。書き込み権限のある認証情報ならそのままマージされ、権限を絞ってエージェントを「提案のみ、適用は不可」にすれば、変更は Inbox で人のレビューを待つ。あるエージェントが書いた Skill は共有の Playbooks カタログに集まり、接続したすべてのエージェントが行動前に同じ手引きを参照できる。データを自分のマシンに置いたままにしたいなら、Cloud Connect が認証済みトンネルでローカルワークスペースを Cloud につなぐ。データは手元に残り、ローカルのエージェントが動き続ける。
複数エージェントの運用パターンは、こう一文で言える。共有のベースは一つ、エージェントはステートレスに。 調査エージェントが起草し、実行エージェントが動き、重要なところは人が承認する。全員が同じ記録を読み、同じ場所に仕事を残す。知識の引き継ぎがベースの中で継続的に済んでいるから、エージェントの交換に引き継ぎは要らない。記憶を共有しないエージェントが10台いてもチームにはならない。全員が読み書きする一つのベースが、彼らをチームにする。
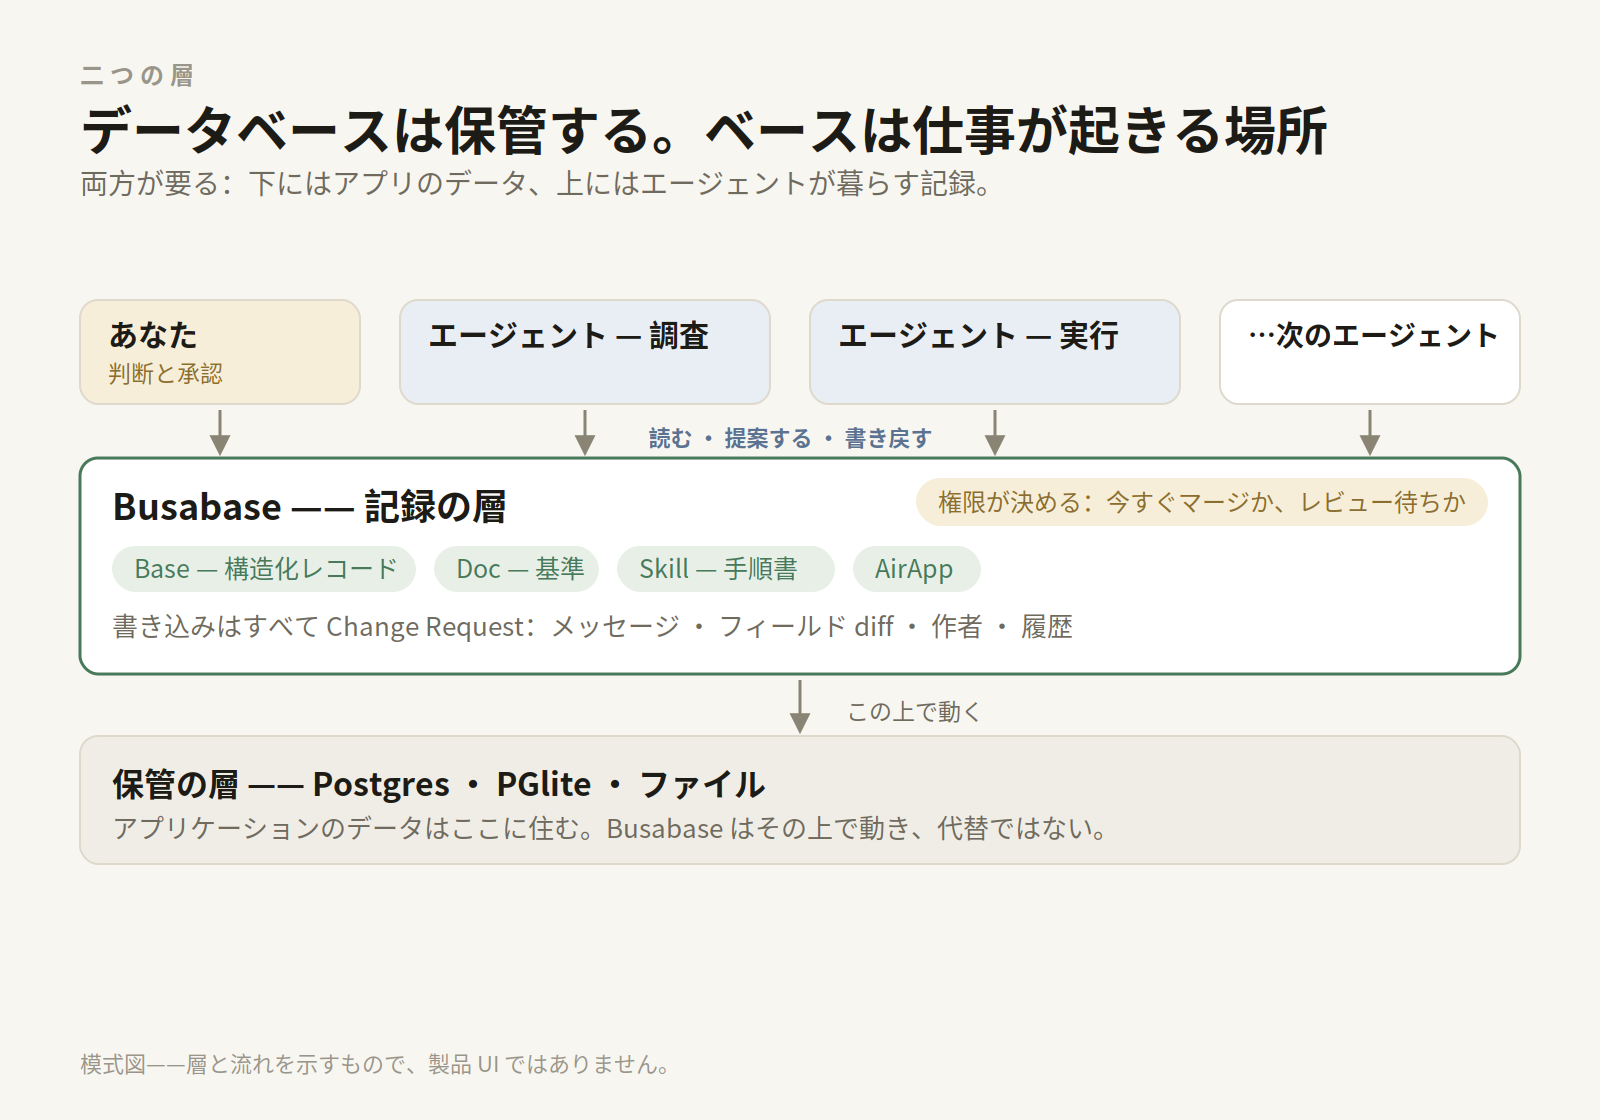 データベースは保管する。記録層は仕事が起きる場所——二つの層は競合ではなく、組み合わさる。
個人データベースに入れてはいけないもの
番組自身の例——財務、健康、人間関係——こそ、個人データベースに容量だけでなく境界が要る理由だ。
- 秘密は絶対に入れない。 パスワード、トークン、リカバリコードをレコードに保存しない。「どこに保管してあるか」の参照だけを置き、中身は置かない。
- 一括コピーではなく参照を。 契約書や医療ファイルは、あなたの管理下でリンク/添付できる。エージェントがチャットへ引用して戻すようなフィールドに、機微な全文を貼らない。
- 機微なカテゴリには明示的な範囲を。 健康や財務を記録するなら、どのエージェントがその Base を読めるのかを決め、その決定を「How I work」Doc に書く。
- 判断はあなたに残す。 お金、約束、日付に関わることは、エージェントが提案し、あなたが決める。このベースの仕事は、その決定を「情報に基づき、記録に残る」ものにすることであって、決定そのものを自動化することではない。
まず、1週間分の会議を入れてみる
大がかりな移行プロジェクトは要らない。サーバーを起動し、プロンプトを貼り、現実の1週間を入れる。会った人、行った決定、直した学びを一つ。それから2週目に、セットアップをしたのとは別のエージェントに聞いてみる。「先週、私たちは何を決めた? なぜ?」ベースから答えが返ってくるなら——返ってくる——あなたは Lightcone のあの回が指していたものを手に入れている。自分のデータベースであり、しかもエージェントが実際にその中で働けるデータベースを。
- コードとセルフホスト:github.com/busabase/busabase
- デスクトップ版:busabase.com/download
- テンプレートから始める:busabase.com/templates
- ドキュメント:busabase.com/docs