Supabase と Busabase の最大の違いは「記憶とルール」の層
Supabase はデータベース——アプリのデータを担う。Busabase はその上の層:記録=記憶、Doc=方針、Skill=ルール、Change Request=ガバナンス。GBrain が手作りした層を、Busabase は標準で備える。

それは、ごく普通の会話の途中で届いた、2通の短いメッセージでした。
「Busabase には、記憶とルールのフレームワークが内蔵されているの?」
「それが Supabase との一番の違い?」
答えは「はい」です。ただ、この一文は丁寧に答える価値があります。短く言うと、間違った場所に目が行きやすいからです。Supabase と Busabase の違いは、「片方がデータベースで、もう片方はそうではない」ということではありません。違いは、ここにあります。
データベースは保存する。Busabase は記憶し、ルールに従って動き、痕跡を残す。
Supabase はデータベースです。あなたのアプリケーションのデータを、信頼性高く、大規模に保持します。エージェントの記憶をそこに置くこともできます——Garry Tan の GBrain は、共有モードを Supabase 上で動かしています。しかし、記憶の構造、エージェントが守るべきルール、書き戻しの規律、そしてすべての変更の履歴とレビューは、データベースが備えているものではありません。Supabase の上では、その層は自分で作ります。Busabase では、それが内蔵されています。Base が記憶、Doc が常駐の方針、Skill がルール、そしてすべての書き込みが、作者と履歴を持つ Change Request として届きます。本稿では両側を正直に説明します——Supabase が端的に正しい選択になる場面も含めて。
Supabase はデータベースである——とても良いデータベース
Supabase は自らを「Postgres 開発プラットフォーム」と呼びます。その通りです。プロジェクトごとに完全な Postgres データベースがあり、その周囲にアプリケーションバックエンドが必要とするものが揃っています。Row Level Security を備えた Authentication、大きなファイルを扱う Storage、リアルタイム同期の Realtime、サーバーレスコードの Edge Functions、即時使える Data APIs、そして同じ Postgres の中でベクトル埋め込みを保存・索引・検索する Vector。オープンソースであり、この仕事ぶりは見事です。アプリケーションを世に出すなら、真剣で堅実な土台です。
このリストの性質に注目してください。すべて「保存」と、その周辺のサービスです。データベースは行とファイルとベクトルを忠実に保持します。しかし、それが「記憶」とは何かを知ることはありません。どの事実をエージェントが残すべきか、人と会社と意思決定がどう関係するのか、常駐ルールは何か、昨日エージェントが書いたものを誰が変えられるのか——データベースは、それらについて意見を持ちません。
だからこそ、一見正しく聞こえるこの文は、半分しか正しくありません。「エージェントの記憶は Supabase に保存できる」。保存はできます。何でも保存できるのと同じ意味で。GBrain はその証拠であり、同時にもう半分の証拠でもあります。Tan は GBrain の共有デプロイを Supabase の Postgres + pgvector 上で動かし、彼自身のブレインは 155,795 ページ、24,589 人、5,340 社にまで育ちました。しかし、その構造のどこにも、データベース由来のものはありません。GBrain そのものが、その上の層なのです。独自の規約を持つ Markdown ページのリポジトリ、保存された断片の上を検索するエンジン、エージェントに取り込み・拡張・維持の方法を教えるスキルのライブラリ、そして夜通しその維持作業を行う数十の定期ジョブ。Supabase は GBrain のデータを保存しています。GBrain は記憶とルールのフレームワークです——そしてそれは、Tan が自分で設計し、自分で作ったものでした。
これは、どちらのプロジェクトへの批判でもありません。一つの仕事の説明です。問いはただ、その仕事を自分でやりたいかどうかです。
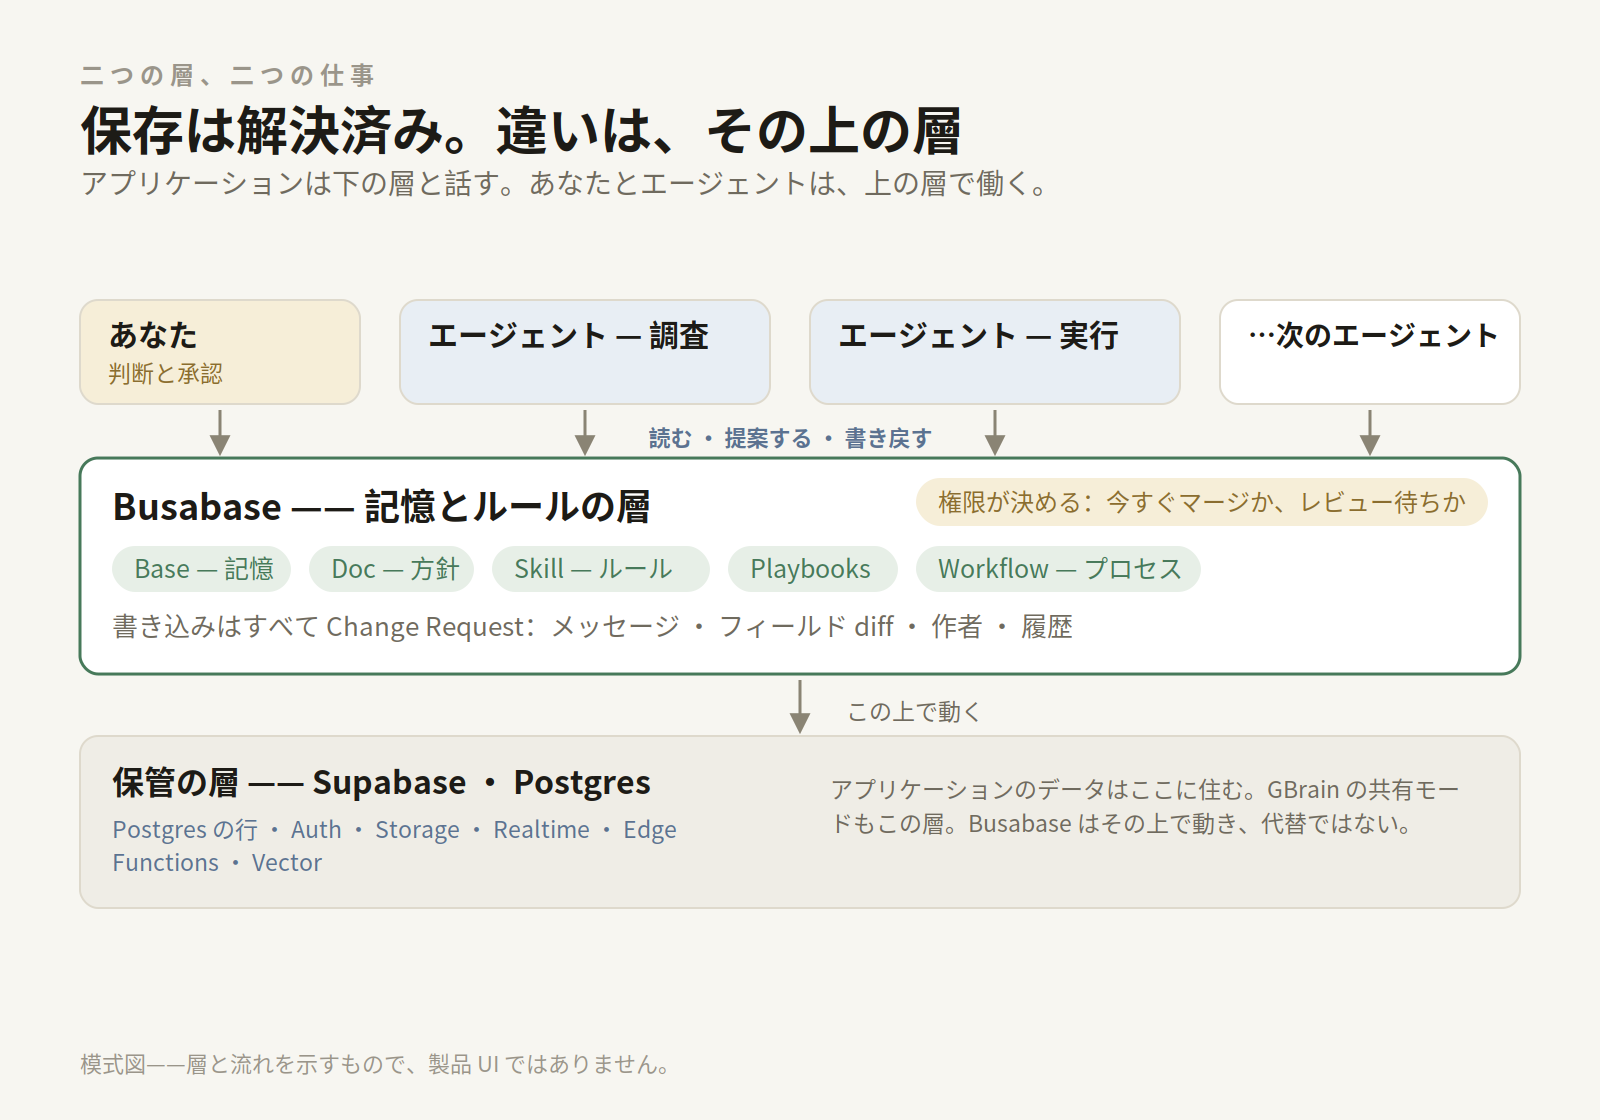
模式図——二つの層がそれぞれ何を保持するか。製品 UI ではありません。
素のデータベースの上では、フレームワークは「あと5つのプロジェクト」
自分で運用するデータベースの上に、エージェントに本物の記憶を与えようと決めたとします。保存は初日です。フレームワークの仕事は、そこから始まります。5つの部品です。一つひとつは小さいですが、欠ければ必ず露呈します。
- 記憶の構造。 何が「1つの記憶」なのか。人、会社、会議、意思決定をどう表し、どう結びつけるのか。データベースでは、あなたが設計するスキーマです。ファイルの山では、あなたが守り続ける規約です。どちらにせよ設計はあなたの仕事で、すべてのエージェントが同じ書き方で書かなければなりません。
- 検索。 保存したことは、覚えていることとは違います。今回のタスクで、エージェントの文脈に何を引き込むかを決める何かが必要です。検索、順位付け、グラフ走査、統合。GBrain の検索層に専用の評価リポジトリが付いているのは、この部品だけで一つのプロジェクトだからです。
- ルールの置き場所——と、その執行。 常駐の方針(「日付を約束しない」「価格は常に最新の表から」)は、エージェントが行動する前に実際に読む場所に置かなければならず、その権威はプロンプトの丁寧さに頼れません。あるエージェントの設定に埋もれたルールは、そのエージェントと一緒に消えます。
- 書き戻しの規律。 記憶が複利になるのは、結果が戻ってくるときだけです。タスクのたびに、出典を付け、重複を除き、1つ目の構造で書き戻す。データベースは、エージェントにこれをさせる仕組みを持ちません。規約です——「デフォルトでそうなる」機械をあなたが作るまでは。
- 承認と権限。 エージェントは速く書き、ときどき間違えます。どの書き込みが即座に反映され、どれが人の判断を待つのか。機微な部分を誰が読めるのか。悪い書き込みをどう追跡し、戻すのか。データベースがくれるのはロールと Row Level Security という素材であって、人が判断できる diff を備えたレビューの流れではありません。
GBrain が称賛されるのは、一人の人間がこの5つをすべて作り、良く作り、155,000 ページの規模でも一貫させ続けたからです。ほとんどのチームはそうしません。できないからではなく、フレームワークが「1つ目のプロダクトの中に隠れた2つ目のプロダクト」だからです。
Busabase:フレームワークそのものがプロダクト
Busabase はデータベースの上の層であり、まさにこの5つの部品であるように作られました。「エージェントの記憶」がプロジェクトではなく、開けば使えるワークスペースになるように。自らも Postgres(または組み込みの PGlite)の上で動き、README にはっきり書かれています。これは上にあるワークスペースであり、あなたのアプリのデータベースの代替ではない、と。Busabase が加えるのは、フレームワークです。
- Base が記憶の層。 人、意思決定、プロジェクト、学びは、型付きで相互に関連したレコードです。あなたが一目で読め、接続したどのエージェントでも検索でき、人とエージェントで同じ構造を共有します。記憶には形があり、その形は共有されています。
- Doc が常駐の方針。 長く効く指針——何を入れ、何を決して入れないか、レッドラインはどこか——は、同じワークスペースの中のドキュメントとして住み、他のすべてと同じように版管理されます。あるエージェントのシステムプロンプトの中ではありません。
- Skill がルールであり、一級のノード。 Skill はエージェントが読めるファイルツリーで、それが司る Base の隣に住みます。エージェントは行動する前にそれを読みます。変更は Change Request を通じてのみ行われるため、ルールの「現在の版」と「変更履歴」は同じものです。しかも Skill は複利になります。エージェントが記録として提出した学びを、人がレビューし、採用し、Skill へ昇格させる——そのループは、自己改善するエージェントの作り方で詳しく扱いました。
- Playbooks がルールを見つけやすくする。 すべての Skill と、すべてのノードのカスタムプロンプトは、一つのカタログに集められます。エージェントは仕事に取りかかる前にそれを検索します。「ここではこの仕事をどうやるのか」に答えは一つだけで、どのエージェントも同じ方法でたどり着きます。5つの道具に5つの習慣、ではありません。
- Workflow はフレームワークの実行部品。 Workflow は、プロセスをグラフとして描き、それが作用するレコードと同じツリーの中に置きます——そして、それは動きます。手動で起動することも、レコードの変更をきっかけに起動することもできます。それがランタイムの第一版であり、すでに今日の姿です。最近のリリースが、それをさらに細かくしました。フィールドが変化したときだけ——あるいは特定の値に「なった」ときだけ——起動する。すでに「準備完了」のレコードが再編集されても、誤って発火することはありません。スケジュールで動かす——間隔、毎日、毎週。編集者自身のタイムゾーンで計算します。カスタムヘッダー付きで Webhook を呼ぶので、認証の要るエンドポイントにも届きます。承認ステップの承認者は、アドレスを手入力するのではなく、メンバーの名簿から選べます。Skill と同じ要点です。プロセスはワークスペースに一度書き定められ、毎回同じ定義で実行されます——実行のたびに作り直すものでも、一つのエージェントの中にだけ住むものでもありません。
- Change Request がガバナンス。 エージェントのすべての書き込み——レコードも、ルールも、ドキュメントも——は、メッセージ、フィールド単位の diff、作者、履歴を備えた Change Request として届きます。その場で反映されるか(書き込み権限のあるキーなら既定でこちら)、人の判断をインボックスで待つかは、権限が決めます。
changeRequestレベルに制限された認証情報は、提案しかできず、自力で変更を確定させることは決してできません。エージェントの書き込みが、単に「保存された」のではなく「効力を持つ」のは、このためです。名前のある提案者、見える diff、そしてマージ後も残る決定があるからです。
今日セットアップするなら、スターターの形はこうなります。
| ノード種別 | 推奨名 | 何を保持するか | 目的 |
|---|---|---|---|
| フォルダ | Agent HQ | 以下のすべてを一つの場所に | 記憶とルールとプロセスの、ひとつの家 |
| Base | Memory | 型付きレコード:人、意思決定、事実——それぞれに出典と状態 | すべてのエージェントが共有する記憶 |
| Doc | Standing policy | 入れるもの、決して入れないもの、承認のレッドライン | エージェントが前提として読む方針 |
| Skill | House rules | 方法、書き戻しの規律、重複排除キー、報告形式 | 複利になるルール |
| Workflow | Weekly review | レビューのプロセスをグラフで、レビュー対象のレコードの隣に | 人が替わっても残るプロセス |
スターター設計——名前とフィールドは、自分の仕事に合わせて調整してください。
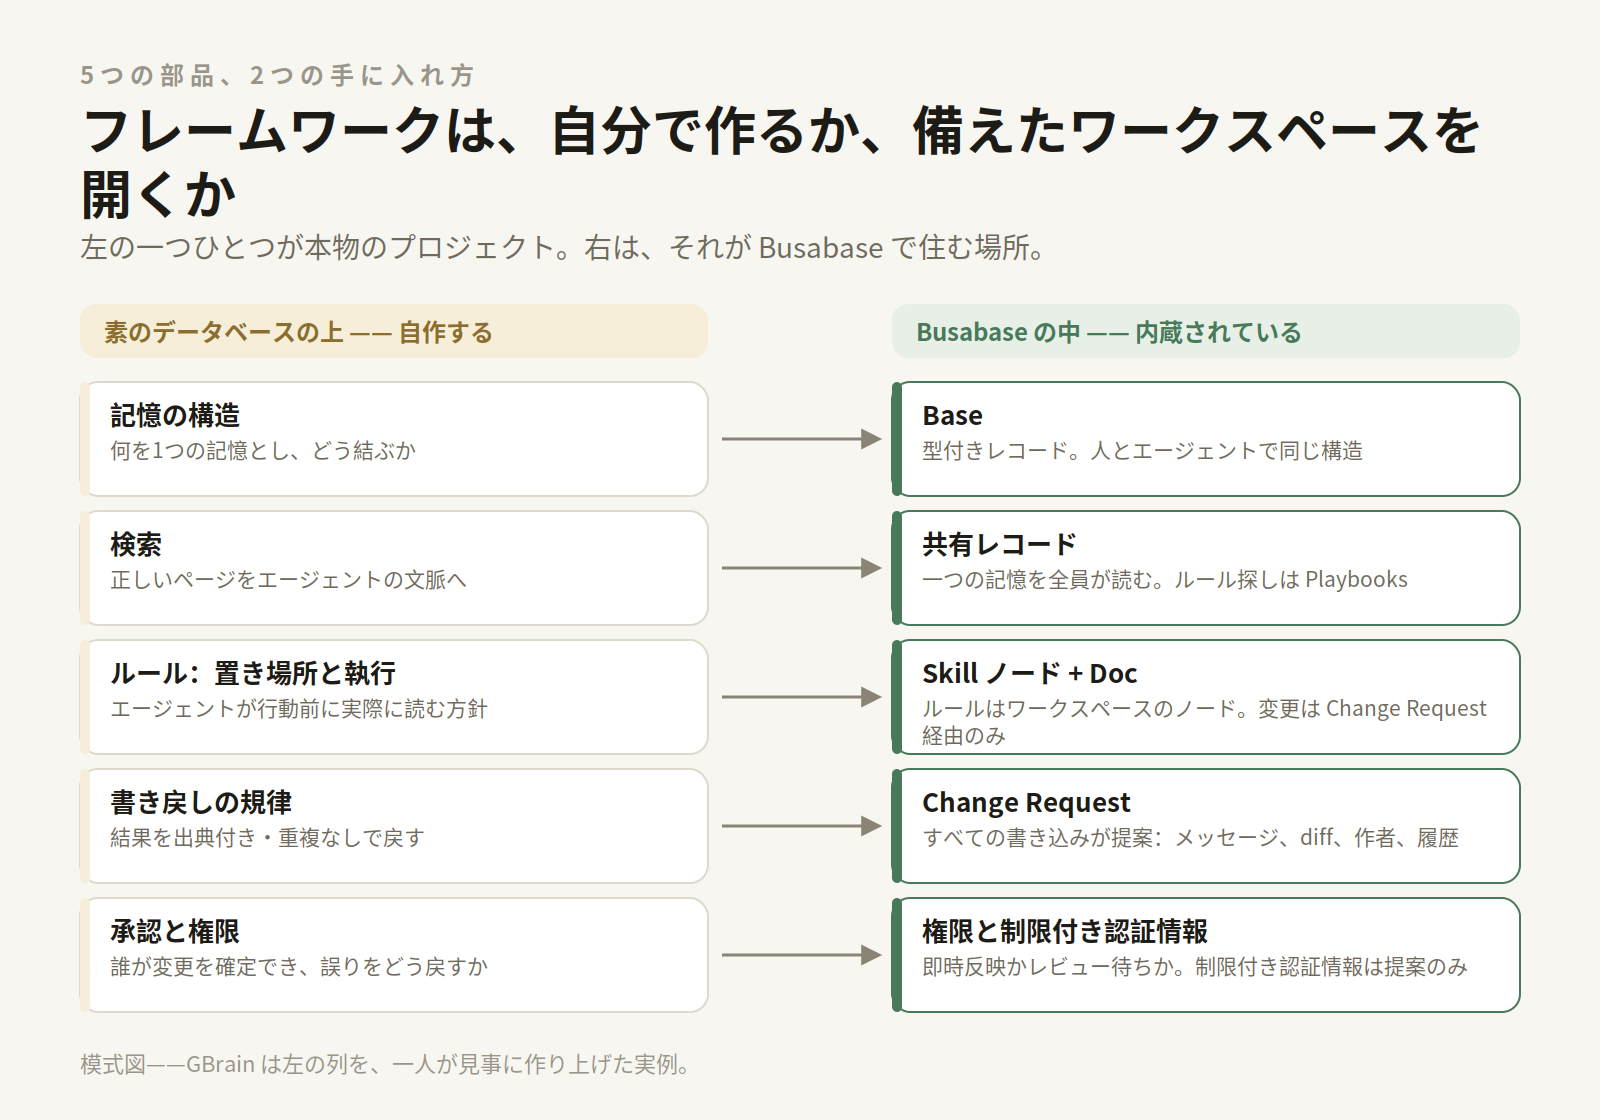
模式図——GBrain は、左の列を手作業で立派に作り上げた実例です。
正面比較
| 観点 | Supabase | Busabase |
|---|---|---|
| 何を保存するか | あなたのアプリケーションのデータ:Postgres の行、ファイル、ベクトル | エージェントの作業記憶:型付きレコード、ドキュメント、Skill、プロセス定義 |
| 誰が読むか | あなたのアプリケーションコードと、開発者 | 人とエージェントが、同じワークスペースで、同じレコードを |
| ルールはどこにあるか | あなたのコードとプロンプトの中——あるいはエージェントの環境にインストールされるスキルパックの中。どちらもプラットフォームの外 | Skill ノードと Doc の中。ワークスペース内で、版管理とレビューが可能 |
| 変更はどう記録され、レビューされるか | 履歴とレビューの流れは自作(ロールと RLS はその素材) | Change Request:フィールド diff、作者、履歴、巻き戻し。レビューするかは選べる |
| エージェントを替えたとき | 以前のエージェントが自分の文脈やファイルに溜めたものは取り残される——共有の層を自分で作っていない限り | 何も移すものはない:記憶もルールも Playbooks も、エージェントの中ではなくベースの中にある |
| 自分で作るもの | 記憶とルールのフレームワーク全体(GBrain がその参照実装) | 中身そのもの:あなたの仕事のレコード、方針、Skill |
どちらの列も、もう一方への断罪ではありません。「保存する」という行為を含む、異なる層です——この比較が人を混乱させるのは、まさにそのためです。
積み重ねる:どちらの層を、いつ使うか
Supabase を選ぶとき。 アプリケーションのバックエンドを作っているときです。ユーザーアカウント、リアルタイム機能、ファイルストレージ、アプリケーション規模の SQL とベクトル検索。それは Supabase の本領であり、そこで卓越しています。Busabase はその仕事の候補ではありません。アプリのバックエンドを装うこともありません。
Busabase を選ぶとき。 保存されるものが、エージェントの記憶と、彼らが従うルールであるときです。覚えていなければならない人と意思決定、守らなければならない方針、人がレビューできなければならない書き込み。そのフレームワークこそが、プロダクトです。
両方を使うとき。 ——エージェントを深く使うチームにとっては、たいていこちらです。アプリケーションのデータは Supabase に。エージェントの共有記憶、常駐の方針、Skill は Busabase に置き、接続するどのエージェント——Claude Code、Codex、Cursor、自作のもの——も、同じガバナンスの下で読み書きします。層が積み重なるのは、そもそも競合していなかったからです。Busabase 自身が Postgres の上で動いています。
次の一手:記録の層へのオントロジー(開発中)
フレームワークの次の層は開発中です——記録の層への Ontology(オントロジー) です。まだ使えないので、何のためのものかを述べておきます。既存の Base の上に、チームが日々口にする業務オブジェクト——Company、Contact、Deal——とその間のつながりを定義します。基になるデータをどこかへ複製することはありません。人とエージェントは一つの語彙を共有し、各オブジェクトは元のレコードまで遡れます。オントロジーも、本稿の他のすべてと同じガバナンスの下にあります。その変更も Change Request を通ります。構造化された記憶は「見つけられる」もの。実体と関係が明示的に定義された記憶は、将来接続するすべてのエージェントに、同じ読み方で「解釈できる」ものです。状態は率直に述べておきます。開発中で、まだ提供されていません。本稿の主張は、その有無に依存しません。
よくある質問
Supabase をエージェントの記憶として使えますか? 保存はできます——GBrain がそうしています。データベースから得られないのはフレームワークです。記憶の構造、ルールの層、書き戻しの規律、エージェントの書き込みのレビューは、あなたが設計し、維持するものです。その構築こそが面白い部分なら、正当なプロジェクトです。そうでないなら、それは Busabase が取り除く部分です。
エージェントのデータベースへの書き込みに「効力」を持たせるのは何ですか? 書き込みそのものではなく、その周囲で起きることです。Busabase では、エージェントの書き込みは Change Request です。作者を名乗り、フィールド単位の diff を示し、あなたが設定した権限のもとで反映されるか、人の決定を待ちます。そして軌跡全体がマージ後も残ります。表にただ現れた行は「保存」です。来歴を持つ変更が「効力」です。
どちらか一方を選ばなければなりませんか? いいえ。答えている問いが違います。Supabase は「私のアプリケーションのデータはどこに住むのか」に答えます。Busabase は「私のエージェントはどこで記憶し、どのルールの下で働くのか」に答えます。多くのチームは両方を、一つの層の上にもう一つを重ねて使うでしょう。
欠けている層から始める
エージェントに保存する場所はすでにあるのに、忘れ、決め直し、痕跡なく書き続けているなら、欠けているのはストレージの追加ではなく、その上のフレームワークです。本シリーズの前稿「誰もが自分のデータベースを持つ時代へ」では、オープンソースの Busabase を1コマンドでインストールし、セットアップ全体をエージェントに渡すコピペ用プロンプトを掲載しました。この比較の背後にある分類については「エージェントの記憶、知識ベース、記録システム」を、常設の選択ページは Busabase vs Supabaseを、Notion との組み合わせ方は Busabase:Notion × Supabase ハイブリッドをご覧ください。
- コードとセルフホスティング:github.com/busabase/busabase
- デスクトップ版:busabase.com/download
- ドキュメント:busabase.com/docs