企業の原子単位はナレッジワーカーではなく、ワークフローだ
Palantir の過去最高の決算説明会で、CTO の Sankar は「企業の原子単位はワークフローだ」と言い、CEO の Karp は根拠を持たないエージェントを「事実上無限の責任」と警告した。その主張の核心と、ひとつのワークフローを記録・ルール・承認の上に実際に載せる方法。

11月2日の引け後、Palantir は上場以来最強の四半期決算を発表した。売上高は23億1300万ドル(前年同期比+96%)、米国の商業売上は+148%で、史上初めて米国の政府売上を上回った。GAAP 純利益は11億2800万ドル、通期ガイダンスは中央値で9ポイント引き上げられた。数字は一週間もすれば消費される。しかしこの決算説明会で述べられた「主張」のほうは、もっと長く引用される価値がある。
それを二度言ったのは、CTO の Shyam Sankar だ。用意した発言の中で一度、そして説明会の最後に、求められてもいないのに自らもう一度繰り返した。
"The atomic unit of the enterprise is not the knowledge worker. It is the workflow."
(企業の原子単位はナレッジワーカーではない。ワークフローだ。)
CEO の Alex Karp は、同日夜に公開された株主書簡の中で、同じことを別の面から書いている。大規模言語モデルは、それ単体では最良の場合でも生む価値は限られ、より可能性の高い結末として "agents of chaos"(混沌の代理人)になる、と。
"Lacking a grounding in the means of interfacing with the labyrinth of datasets, people, business units, use cases, and critical safeguards scattered across the modern enterprise, the LLM agent is a virtually unlimited liability, possessing a nearly unbounded destructive potential and a blast radius that tends towards infinity."
(現代の企業に散在するデータセット、人、事業単位、ユースケース、重要な安全策が織りなす迷宮と接続する根拠を持たない LLM エージェントは、事実上無限の責任であり、破壊の潜在力はほぼ無限で、その爆発半径は無限大に近づく。)
先に立場を明らかにしておく。Palantir はまさにこの二文が論証する層の製品を売っている。主張には自社の商業的利益が付着している。しかしこれはスローガンではない。自社の AI プログラムに一行ずつ照らして検証できる、一組の主張だ。本稿はその検証を行い、続いて、その主張に従うとは具体的にどういうことかを、普通のチームが今週から始められるワークスペースの中で示す。
主張の核心:五つの論点は、一つの文に収束する
1. 単位が間違っている。 Sankar によれば、モデル開発側は「企業の原子は個々のナレッジワーカーだ」と思い込んでいる。だから業界の標準製品は「全社員にアシスタントを一人ずつ」になる。しかし "You can make any set of workers more productive and generate no actual ROI"(どんな集団の生産性も上げられるが、実際の ROI はゼロにできる)。個人の生産性を測ることは、投入を測ることだ。気持ちはいいが、何も精算されていない。Sankar 自身が例外を認めている。コーディングのような仕事ではナレッジワーカー自身がワークフローであり、アシスタントはまさに適合する。しかし企業の仕事の大多数では、アシスタントは部品であって、単位ではない。
2. モデル単体は資産ではなく、責任である。 Karp の書簡の一節が最も鋭い形だ。企業のデータセット、人、事業単位、安全策に根拠を持たないエージェントは、「入れれば使える生産性ツール」ではない。無限の責任であり、爆発半径は無限大に近づく。リスクはモデルの弱さではない。データにも、プロセスにも、誰の停止権限にも接続されていないことだ。
3. トークンの層は、価値の層ではない。 Karp は説明会で市場の空気をこう表現した。偽のデプロイ会社、トークンを転売する軽量な会社、トークンの転売を自社売上として計上するソフトウェア会社——"people are just tired of it"(人々はもううんざりしている)。API にトークンを通過させるだけの製品は、「動き」を売ったのであって成果ではない。顧客はその違いに気づき始めている。
4. 野心が、誰が価値を得るかを決める。 これも Sankar だ。AI から本当に価値を得ている顧客は「途方もない野心を持っている。彼らの目標は、OpEx 削減のような冴えないものではない。市場支配だ。そして逆も真なりで、最も苦しむ顧客はコスト削減に狭く集中している」。AI を人の置き換えに無理やり押し込む(shoehorn it to replacing the human)ことは、「この瞬間を完全に見誤る」ことだ。コスト削減の物語は、志が小さいだけではない。席を最適化し、仕事そのものを見ていない。狙う的が違うのだ。
5. お金は目を曇らせる。 D.A. Davidson の Gil Luria に「まだ納得していない CEO をどう説得するか」と問われ、Karp は投資家自身に矛先を向けた。"What happened on Wall Street is everybody invested in these firms early. It's hard to see the reality when you're getting rich on something that's not actually working the way you think it is."(ウォール街で起きたことは、皆が早い段階でこれらの企業に投資したということだ。自分たちが思うようには動いていないもので金持ちになっているとき、現実は見えにくい。)
五つの論点の下にある文は一つだけだ。AI の価値はワークフローの中で精算される——仕事そのものが変わったかどうか、そして顧客自身のプロセスの中で、運営データ、ルール、判断と実行の記録といった、奪われない何かが積み上がっていくかどうか。モデルはその機械の交換可能な部品であり、ワークフローこそが機械なのだ。
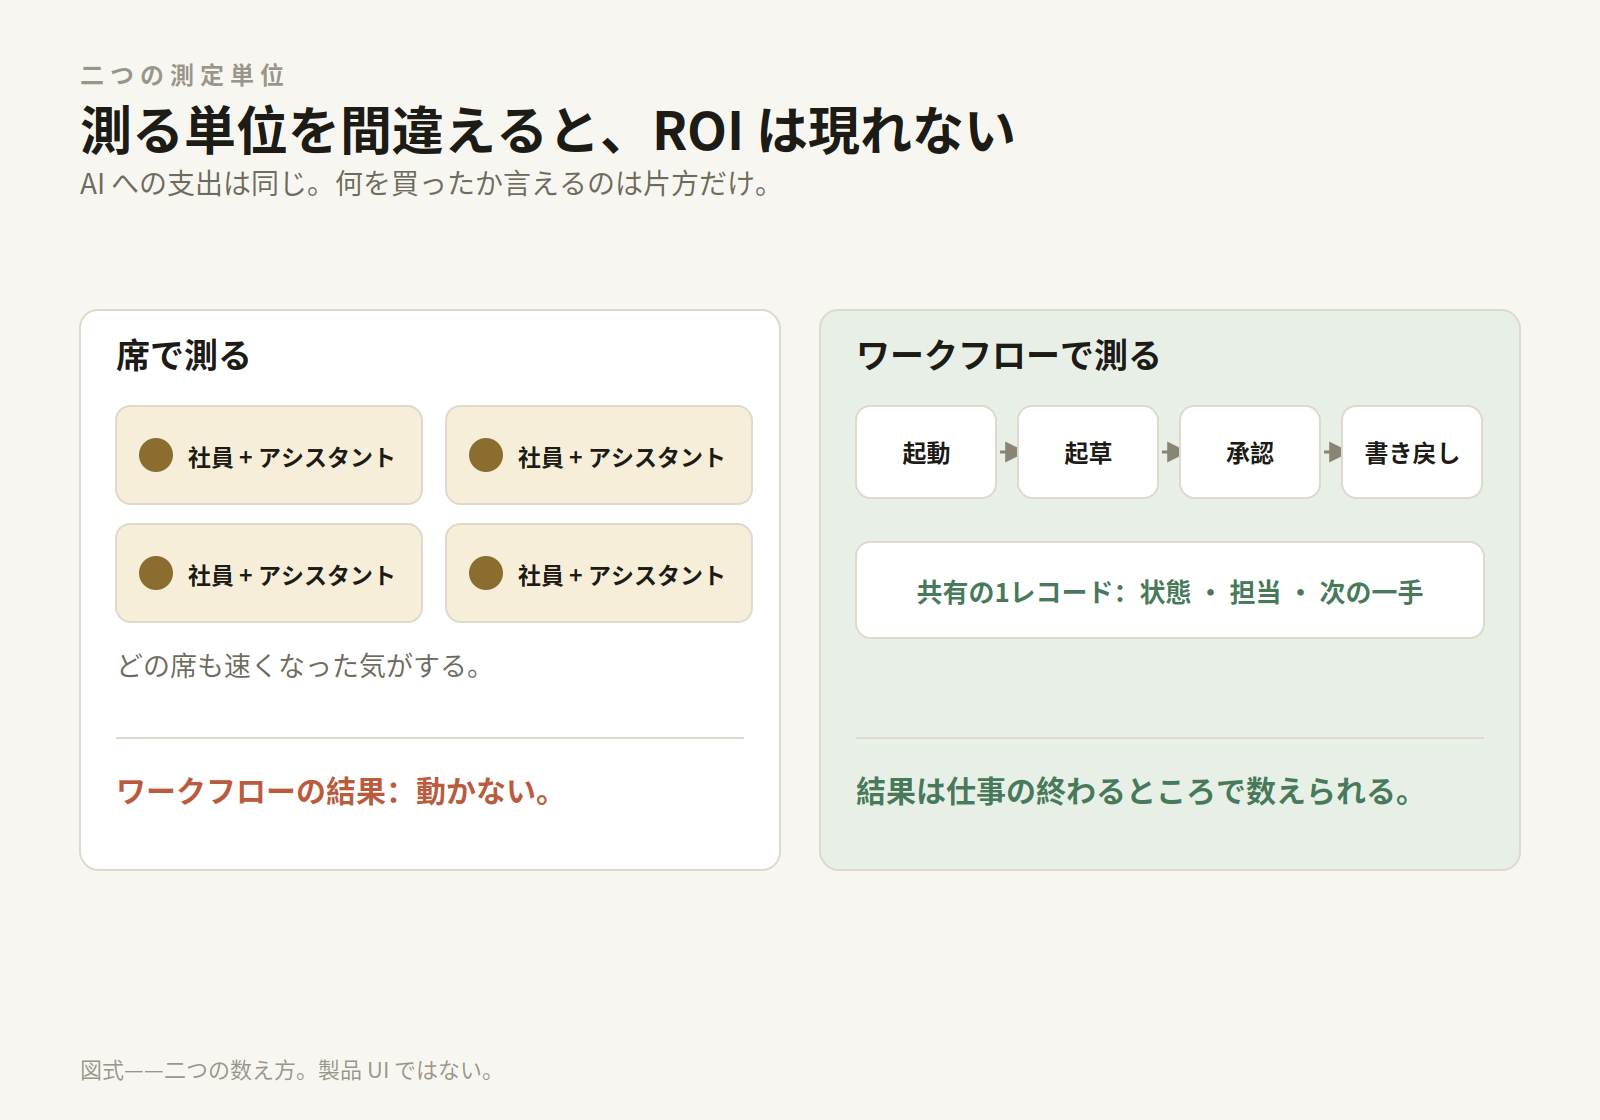
図式——測ることのできる二つの単位と、それぞれが何を精算するか。
堅実な道が「ひとつのワークフロー」から始まる理由
原子単位がワークフローだというなら、実務上の問いは「どのモデルか」「アシスタントの席はいくつか」ではない。ひとつのワークフローはどこに住むべきか——人とエージェントが一緒に回せて、その結果を数えられる場所はどこか。 Busabase が築いているのはその地面だ。より大きなプラットフォームとしてではなく、ワークフローがチャットウィンドウの中ではなく「家」を持つための、最小の部品の組として。
ワークフローの状態は、記録の中に生きる。 ひとつのエージェントのセッションの中にしか存在しないワークフローには、他の誰もが点検できる状態がない。Busabase では、ワークフローが運ぶもの——リード、申請、レビュー、成果物——は Base の中の型付き記録であり、担当者、ステータス、関係を持つ。エージェントが書く記録と、人が読む記録は同じものだ。Sankar が「価値はワークフローに対して生まれる」と言うとき、その主張を検証可能にする帳簿がこれだ。ワークフローの状態も結果も、記録の上に座っている。
自律の前に、接地がある。 Karp の責任の一節は、エージェントが接地すべきものを列挙していた。データセット、人、事業単位、安全策だ。Busabase では、その接地に住所がある。Doc は恒常的な方針を保持する——何が適格なリードか、会社が決して約束しないことは何か。Skill はエージェントが従うべき方法であり、同じワークスペースの中の一級のノードとして、行動の前に読まれる。Playbooks はすべての Skill と各ノードのカスタムプロンプトを一つのカタログに集め、エージェントは仕事を始める前にそれを検索する。「ここではこれはどうやるのか」は、即興ではなく検索で答える。
責任はガバナンスの問題であり、ガバナンスは仕組みの問題だ。 Busabase ではエージェントの書き込みはすべて Change Request として届く。フィールド単位の diff、名前のある作者、そして承認後も履歴に残る判断を備えた提案だ。権限が、書き込みがその場でマージされるか、人の受信箱で判断を待つかを決める。changeRequest レベルに制限された認証情報は、提案はできても変更を単独で成立させることは決してできない。ワークフローの中の承認ステップは、同じ思想をプロセスの内側に置いたものだ。重大な一手は、その責任者の判断を待つ。爆発半径が小さいとは、実際にはこういう姿をしている。システムプロンプトの中の約束ではなく、人が実際に処理するキューだ。
「全員に一人ずつ」ではない。 共有された記録の上で、分業は目に見える。人が判断し、優先順位をつけ、承認する。エージェントが実行し、起草し、書き戻す。ROI の問いの立て方も変わる。「全員が速くなった気がするか」は問わない。ワークフローに問う。何件入って、何件終わり、どこで詰まり、誰がそれを解くのか。その数字は記録そのものの上に生きている。
堅実さとは、しなくてよいことの多さでもある。 既存のスタックを剥がす必要はない。記録の層は、いま動いているデータベースやアプリケーションの上に座る(Busabase 自体も Postgres の上で動く)。会社を一つのモデルに賭ける必要もない。エージェントは Agent Skill、MCP、OpenAPI、CLI、ACP で接続し、下のモデルを交換しても記録・ルール・履歴は自分のものとして残る。そして四十のワークフローから始める必要もない。一つから始め、結果を数えられるまで回し、そこで学んだことを——経験として記録し、レビューし、Skill に昇格させて——次のワークフローを安くする。この複利のループこそ、Palantir の顧客が企業規模で買っているものの、地味な版である。記憶とルールの枠組み自体については、姉妹編のSupabase と Busabase の最大の違いは「記憶とルール」の層を参照してほしい。
ひとつのワークフローを、端から端まで
主張を仕事の大きさに落とす。シナリオはリードのフォローアップ——意図的に選んだ。売上の側の仕事であり、論点4が「価値はそこにある」と言う場所だからだ。これは starter 設計(提案構成)である。名前とフィールドは自社のパイプラインに合わせてもらいたい。
| ノード種別 | 提案名 | 必須の内容 | 役割 |
|---|---|---|---|
| フォルダ | 営業フォローアップ | 以下のすべてを一か所に | このワークフローの記録・ルール・プロセスの家 |
| Base | リード | リード1件につき1レコード:出典、会社、担当者、ステータス、担当、次の一手、期限 | ワークフローの状態——各リードの位置が、人にもエージェントにも見える |
| Doc | ICP と話法の方針 | 誰が適格か、失格条件、会社の文体 | エージェントが起草前に照合する恒常的な方針 |
| Skill | リードフォローアップ担当 | 補完の方法、初回返信の構成、フォローの間隔、書き戻しの規律、重複防止ルール(1リード=1レコード) | 複利していくルール |
| Workflow | 新規リードフォローアップ | プロセスをグラフとして、運ぶ記録の隣に | 人が替わり、エージェントが替わっても、プロセスは残る |
一回の実行。 新しいリードがレコードになる——そのレコードの変化がワークフローを起動する。現在稼働しているランタイムの第一版は、手動の起動と、記録の変化による起動でワークフローを回す。エージェントはレコードを読み、ICP の Doc と照らして会社を確認し、検証できる情報を補完し、会社の文体で最初の返信を起草する。草稿は送信せず、レコードの上に書く。担当者は草稿がある場所でそれを確認し、修正するか承認する。その後に初めて、エージェントは送信し、送信を同じレコードに記録し、間隔に必要なフォローアップのタスクレコードを作る。返信、バウンス、理由付きの却下——結果はすべて同じリードレコードに書き戻される。ステータスも、次の一手も、担当者も欠けた状態でこのワークフローを離れるリードはない。それが完了条件だ。情報が足りなければ、エージェントは捏造しない。レコードは「何が必要か」を書いたタスクとともに担当者へ戻る。
人の側は、エージェントとのチャットで次の一文から始まる。
「営業フォローアップ」フォルダで、「新規」のまま1時間を超えたリードレコードをすべて取り出して。各レコードを ICP と話法の Doc と照合し、最初の返信を起草して、そのレコードの上に置いて。何も送信しないで。キューをここに表示して。私がレコード上で草稿を承認したら、送信し、フォローアップのタスクを設定し、結果を同じレコードに書き戻して。
その後に届いたものを、正直に書く。 執筆時に進行中だった一群のワークフロー機能はすでに提供され、まさにこの実行を精緻にする。フィールドが特定の値に変わったときにだけ起動する——すでに適格なリードが編集されてもプロセスは再起動しない。編集者自身のタイムゾーンで計算されるスケジュール実行。カスタムヘッダー付きの Webhook で、認証の要るシステムにも届く。承認ステップの承認者を、アドレスを手打ちするのではなくメンバー一覧から選ぶ。どれも上記の形は変えない。同じワークフローの、起動条件が細かくなるだけだ。そしてこのワークフローが運ぶ対象——会社、担当者、取引——は、やがてそれ自体の明示的な意味の層を持つ。既存の Base の上にオブジェクトタイプを定義するオントロジーで、現在開発中であり、まだ提供されていない。本稿の主張はそれに依存しない。それは記録の層の、その次の一歩だ。
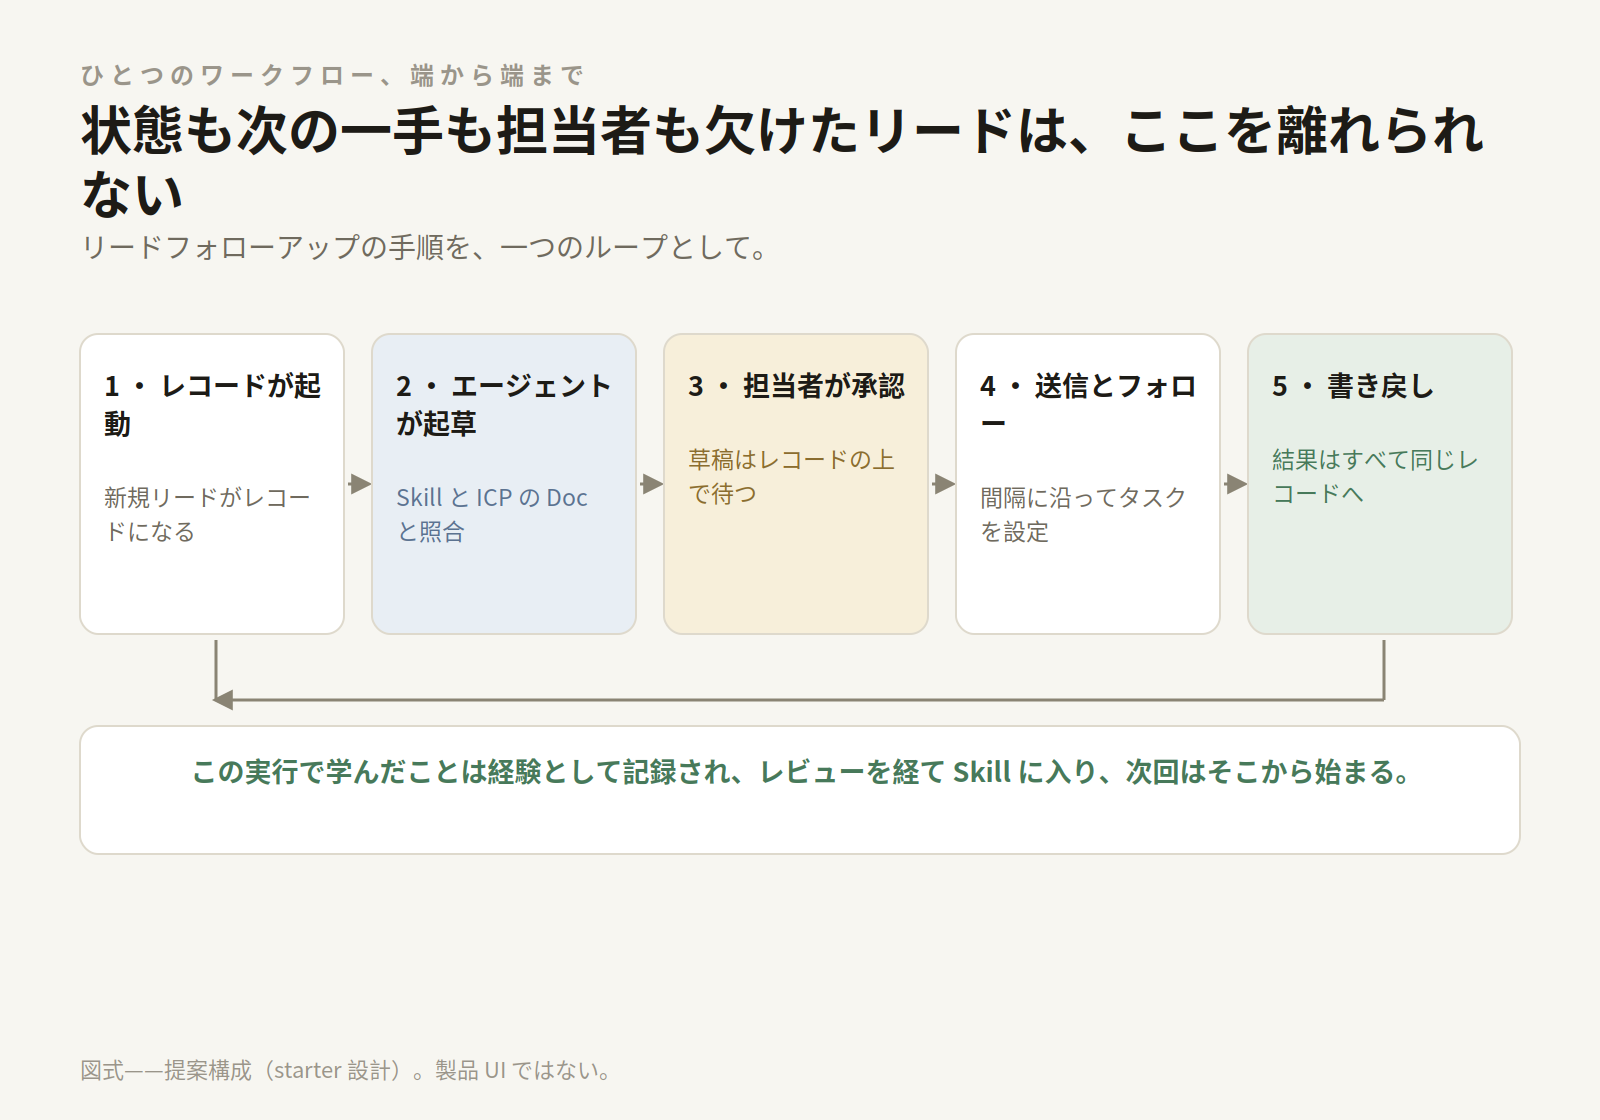
図式——上記の手順を一つのループとして描いたもの。製品 UI ではない。
FAQ
社員一人ひとりのためのアシスタントは、無駄なのですか。 いいえ。Sankar 自身の例外がそれを示している。コーディングの多くがそうであるように、ナレッジワーカー自身がワークフローである仕事では、アシスタントこそが正しい単位であり、適合は優れている。主張の対象は、複数の人・システム・承認にまたがる、企業の仕事の大多数だ。そこではアシスタントはワークフローの中の部品であって、ワークフロー自体の設計の代わりにはならない。
ワークフローの水準で仕事をするには、Palantir 規模の予算が必要ですか。 この議論は小切手の大きさではなく、測る単位についてのものだ。ひとつのワークフローの家は、記録と、恒常的なルールと、レビューされる書き込みである。オープンソース版の Busabase は1コマンドでセルフホストでき、その手順は個人データベースのガイドに書いた。企業向けプラットフォームはこれを企業規模で売るが、規律そのものはひとつのワークフローから始まる。
最初に動かすべきワークフローはどれですか。 結果をすでに数えられるものだ。開始と終了が明確で、責任者が名前で存在し、引き継ぎがいま手作業——チャットのスレッドやスプレッドシート、誰かの記憶の中で起きているもの。その状態がいまどこに住んでいるか言えないなら、それこそ最初に家を与えるべきワークフローだ。
ひとつのワークフローから始める
Karp の書簡と Sankar の主張は、修辞として引用されるだろう。しかしチェックリストとして使うほうが役に立つ。どの AI プログラムにも——Busabase の上に築くものにも——問える四つの問いだ。ワークフローの状態はどこに住んでいるか。ルールはどこに書かれ、誰が変えられるか。どの書き込みが人を待ち、その判断はどこに残るか。前回の実行は、次回に何を残したか。四つすべてに答えられるプログラムは、原子単位の水準で仕事をしている。答えられないものは、席を測っている。
今週の堅実さの検証は一つだけだ。ワークフローを一つ指さして——その状態はどこにあり、ルールは誰が決め、どのステップを誰が承認し、結果はどこに記録されるか——と言えるかどうかだ。一つのワークフローを選び、家を与え、何かを自動化する前に、まず手で一回回してほしい。
- コードとセルフホスト:github.com/busabase/busabase
- デスクトップ版:busabase.com/download
- ドキュメント:busabase.com/docs